Zweck
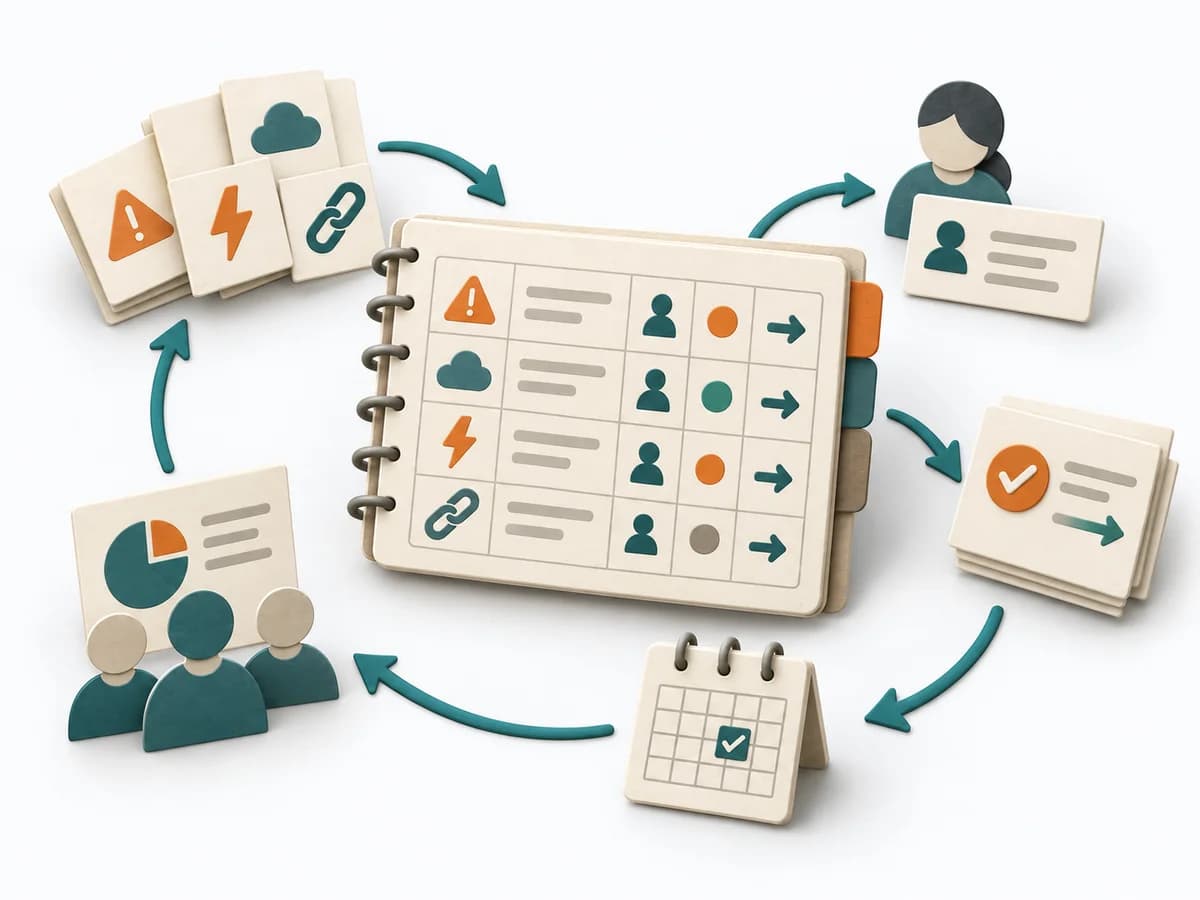
Nach einem Incident mit Schaden oder Beinahe-Schaden schafft die Methode ein nüchternes Lernfeld ohne Schuldzuweisung. Sie richtet den Blick auf Verlauf, Bedingungen und wirksame Gegenmaßnahmen.
DevOps Operative Praxis
Ein Blameless Postmortem untersucht nach einem Vorfall das Zusammenspiel von Systembedingungen und Ereignissen und leitet nachverfolgbare Verbesserungen ab.
Ein Blameless Postmortem untersucht nach einem Vorfall das Zusammenspiel von Systembedingungen und Ereignissen. Die Analyse erklärt, unter welchen Bedingungen die Beteiligten gehandelt haben, und leitet daraus nachverfolgbare Verbesserungen ab.
Welche Bedingungen ermöglichten den Vorfall, und wie reduzieren wir Wiederholung oder Auswirkung?
Die Phasen können iterativ durchlaufen werden; ihre Reihenfolge unterstützt den Einstieg, ersetzt aber kein fachliches Urteil.

Fakten
Vorfall abgrenzen, Beteiligte einladen und Logs, Statusmeldungen sowie Zeitstempel sichern.
Zeitlinie
Ereignisse, Entscheidungen, Signale und Auswirkungen mit Quellen sortieren; Wissenslücken markieren.
Bedingungen
Frage nach Systembedingungen, die Handlungen und Verlauf verständlich machen; keine Schuldperson suchen.
Maßnahmen
Formuliere konkrete Präventions-/Erkennungs-/Behebungsmaßnahmen mit Owner und Termin.
Prüfe Ergebnis und offene Annahmen beim nächsten passenden Termin. Halte Änderungen, Verantwortung und neue Evidenz fest.
Geeignet: Abgeschlossener, auswertungswürdiger Vorfall mit Beteiligten, Faktenquellen und einem sicheren Lernrahmen.
Arbeitsbild mit abgegrenztem Vorfall, Beteiligten sowie gesicherten Logs, Statusmeldungen und Zeitstempeln.
Die Analyse beschreibt Systembedingungen, die Handlungen und Verlauf verständlich machen. Sie richtet den Blick auf Verbesserungen am System.
Konkrete Präventions-, Erkennungs- oder Behebungsmaßnahmen mit Owner und Termin.
Fiktives Lehrbeispiel
Untersuche nach einem Vorfall, wie Systembedingungen und Ereignisse zusammenwirkten, und leite nachverfolgbare Verbesserungen ab.
Notiere Incident-ID, Auswirkung, Zeitraum und Reviewauftrag.
Fiktiv: Buchungsbestätigung verzögert; 23 Minuten, betroffene Sessions dokumentiert.
Ordne Ereignisse mit Quelle und damaligem Informationsstand.
10:02 Konfigurationswechsel; 10:14 Queue-Alarm; 10:25 Rollback; 10:31 Rückstau abgebaut.
Halte Prozess-, Werkzeug- und Systembedingungen sowie Unsicherheit fest.
Alarmgrenze spät; Rollback-Verfahren nicht geübt; gleichzeitig keine automatische Rücknahme.
Ergänze Prävention/Erkennung/Behebung, Owner und Termin.
Warnschwelle prüfen (SRE, 30.09.); Rollback üben (Service-Team, 07.10.).
Fiktiv: Ein Konfigurationswechsel blockiert 23 Minuten lang Buchungsbestätigungen. Alarmierung zeigte Queue-Wachstum erst nach 12 Minuten; Rücknahme gelang nach manueller Eskalation. Bericht hält Zeitlinie, unklare Warnschwelle und fehlenden getesteten Rollback fest. Maßnahmen: Schwelle prüfen, Rollback automatisieren, Eigentümer und Termin zuordnen.
Beginne mit einer abgegrenzten Frage, kläre Zugang und Beteiligte und sichere vorhandene Belege. Untersuche nach einem Vorfall, wie Systembedingungen und Ereignisse zusammenwirkten, und leite nachverfolgbare Verbesserungen ab.
Nach einem Incident mit Schaden oder Beinahe-Schaden schafft die Methode ein nüchternes Lernfeld ohne Schuldzuweisung. Sie richtet den Blick auf Verlauf, Bedingungen und wirksame Gegenmaßnahmen.
Der Vorfall wird so rekonstruiert, dass Fakten und Entscheidungen nachvollziehbar bleiben, ohne Menschen zum Erklärziel zu machen. Dadurch treten systemische Beiträge und Signale aus dem Alltag klarer hervor. Die nachfolgenden Verbesserungen zielen auf Robustheit statt auf persönliche Rechtfertigung.
Ein Blameless Postmortem schafft Lernfähigkeit nach Störungen, weil es Entscheidungen im Kontext rekonstruiert statt Schuldige zu suchen. Timeline, Impact, beitragende Faktoren und Maßnahmen brauchen klare Trennung. Der Nutzen entsteht, wenn das Team bessere Schutzmechanismen, Signale oder Recovery-Pfade ableitet und die Geschichte des Incidents nachvollziehbar bleibt.
Sichere Timeline, Logs, Screenshots und getroffene Entscheidungen, solange der Vorfall noch frisch im Gedächtnis liegt. Die Stimmung bleibt konstruktiv, wenn Formulierungen Bedingungen, Signale und Trade-offs beschreiben statt Personen zu bewerten. Schließe mit Systemänderungen, einem Nachverfolgungsweg und einem Termin, an dem die Wirksamkeit der Maßnahmen überprüft wird.
Die Methodenanleitung führt mit 4 Phasen, Zeitrahmen, 4 Stolperfallen und klaren Abbruchkriterien durch die Umsetzung.
Methodenanleitung öffnenDeine Einschätzung
Mit deinem Feedback hilfst du, den Methodatlas weiterzuentwickeln.
Bereite Blameless Postmortem mit klarer Frage, Rollen und Quellen vor.
Noch zu klären
Noch zu klären
Vollständigen Ablauf planen Zeit: Nach Umfang und verfügbaren Belegen festlegen
Diese Vorlage während der Arbeit auf Papier oder in einem eigenen Dokument ausfüllen.
Notiere Incident-ID, Auswirkung, Zeitraum und Reviewauftrag.
...
Ordne Ereignisse mit Quelle und damaligem Informationsstand.
...
Halte Prozess-, Werkzeug- und Systembedingungen sowie Unsicherheit fest.
...
Ergänze Prävention/Erkennung/Behebung, Owner und Termin.
...
Leere Vorlage: beginne mit einer abgegrenzten Frage. Trage nur erhobene Fakten ein, markiere Annahmen und halte offene Fragen sowie Quellen fest.
Using SRE to meet reliability challenges · Google Cloud
Erwartetes Artefakt: Abgegrenzter Incident mit gesicherten Quellen
Abgegrenzter Incident mit gesicherten Quellen
Eintrag:
...
Erwartetes Artefakt: Quellenbasierte Zeitlinie
Quellenbasierte Zeitlinie
Eintrag:
...
Erwartetes Artefakt: Systemische Beitragsbedingungen statt Schuldzuweisung
Systemische Beitragsbedingungen statt Schuldzuweisung
Eintrag:
...
Erwartetes Artefakt: Nachverfolgbare Verbesserungsmaßnahmen
Nachverfolgbare Verbesserungsmaßnahmen
Eintrag:
...
...
Methodenanleitung: https://methodatlas.meierhoff-systems.de/de/methods/blameless-postmortem/run-sheet
Passende Alternativen mit Entscheidungshilfe, danach weitere verwandte Methoden.
Statt Blameless Postmortem, wenn ihr nach einem Ereignis rasch lernen und konkrete Verbesserungen festhalten wollt.
Ordnet Ereignisse, Entscheidungen und Verzögerungen chronologisch und macht Ursachen sowie Lernpunkte sichtbar.
Verlegt Incident Response in einen gemeinsamen Thread, verbindet Alerts mit Commands und macht Entscheidungen nachvollziehbar.
Simuliert realistische Störungsszenarien, deckt Lücken in Response und Runbooks auf und verbessert Vorbereitung.
Untersucht einen Vorfall mit Blick auf Entscheidungen, Annahmen und Systemfaktoren und hält Lernergebnisse fest.
Macht Muster aus einem Sprint sichtbar und leitet daraus konkrete Verbesserungen für den nächsten Arbeitszyklus ab.