Methoden Seite an Seite ansehen.
Wähle bis zu vier Methoden. Ergänze sie über die Suche und teile den Vergleich über seinen Link.
| Kriterium |  Facilitation Open Space Technology |  DevOps Blameless Postmortem | 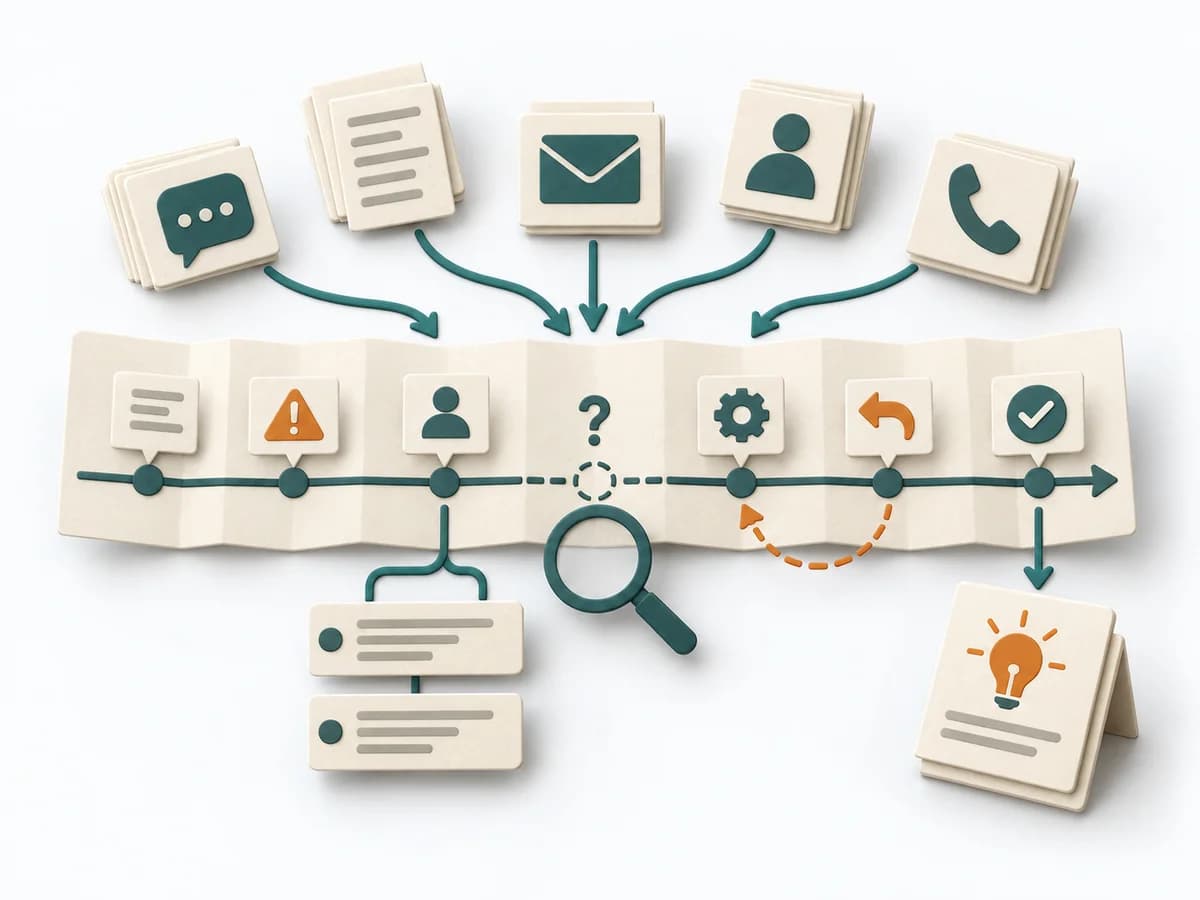 DevOps Incident Timeline Analysis |  DevOps Incident Command |
|---|---|---|---|---|
Zweckunterschiedlich | Wenn ein komplexes Thema noch keine passende Agenda hat, gibt Open Space Technology den Beteiligten die Themenhoheit zurück. Das Format eignet sich für Fragen, die nur dann vorankommen, wenn echtes Interesse die Reihenfolge bestimmt. | Nach einem Incident mit Schaden oder Beinahe-Schaden schafft die Methode ein nüchternes Lernfeld ohne Schuldzuweisung. Sie richtet den Blick auf Verlauf, Bedingungen und wirksame Gegenmaßnahmen. | Bei einem Incident mit unklarer Reihenfolge macht die Methode den zeitlichen Verlauf präzise sichtbar. Sie trennt Wahrnehmung, Reaktion und Verzögerung, damit Ursache und Wirkung sauberer lesbar werden. | Bei einem akuten Incident mit mehreren Beteiligten schafft die Methode eine klare Führungs- und Kommunikationsstruktur. Sie reduziert Chaos, wenn schnelle Koordination und saubere Lageführung gleichzeitig gebraucht werden. |
Komplexitätunterschiedlich | Hoch | Mittel | Mittel | Mittel |
Zeitunterschiedlich | 0.5-2 Tage | 30-90 min | 60-180 min | As needed |
Teilnehmendeunterschiedlich | 20-500+ | 3-12 | 3-10 | 4-15 |
Formatunterschiedlich | Workshop | Workshop + Async | Workshop + Async | Workshop + Async |
Outputunterschiedlich | Session Marketplace, Proceedings, Action Topics | Postmortem Doc, Action Items, Timeline | Incident Timeline, Evidence Log, Delay Analysis, Improvement Actions | Incident Log, Action Tracker, Stakeholder Updates |
Tagskeine Überschneidung | FacilitationGroßgruppeAutonomie | Site Reliability EngineeringIncidentLernenZuverlässigkeit | IncidentZeitleisteSite Reliability Engineering | IncidentOperationsZuverlässigkeit |