Methoden Seite an Seite ansehen.
Wähle bis zu vier Methoden. Ergänze sie über die Suche und teile den Vergleich über seinen Link.
| Kriterium |  Delivery MoSCoW | 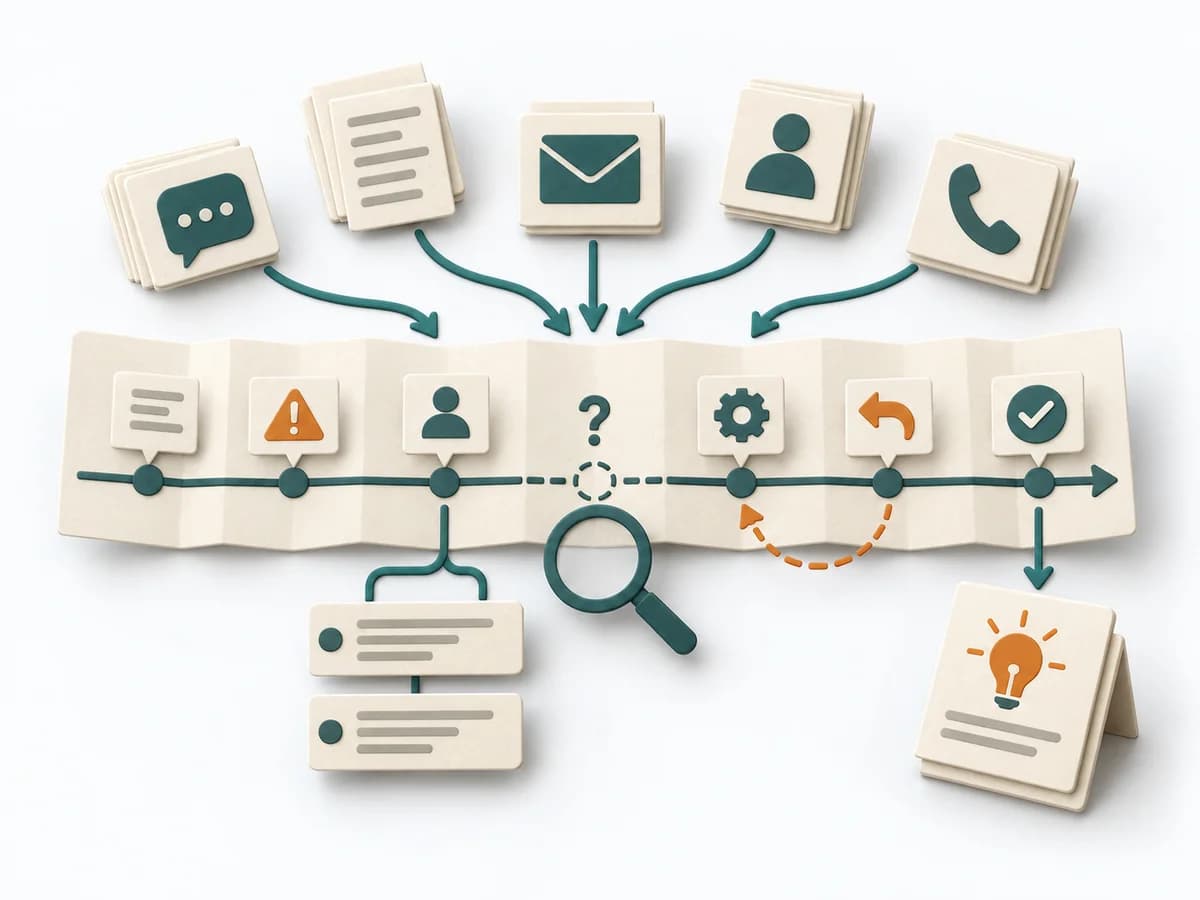 DevOps Incident Timeline Analysis | 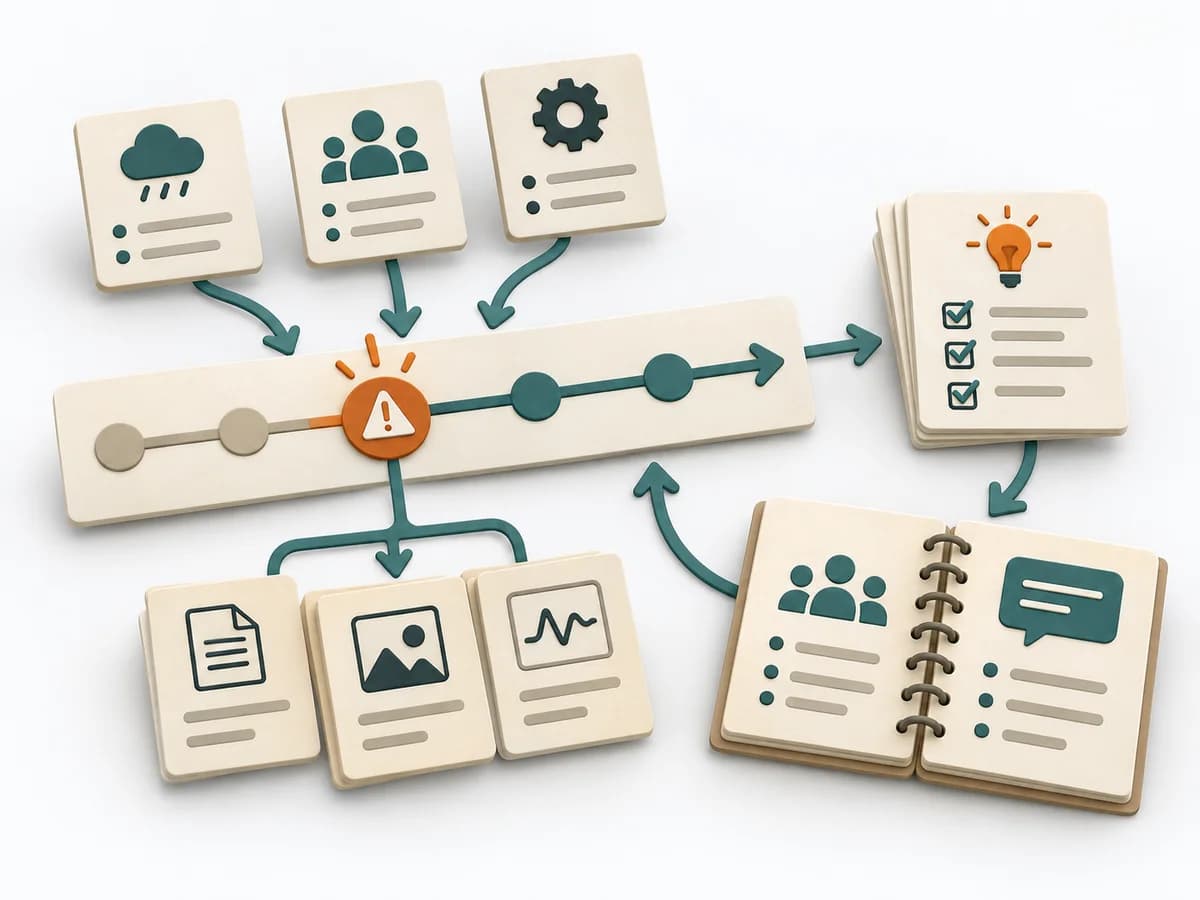 DevOps Blameless Postmortem | 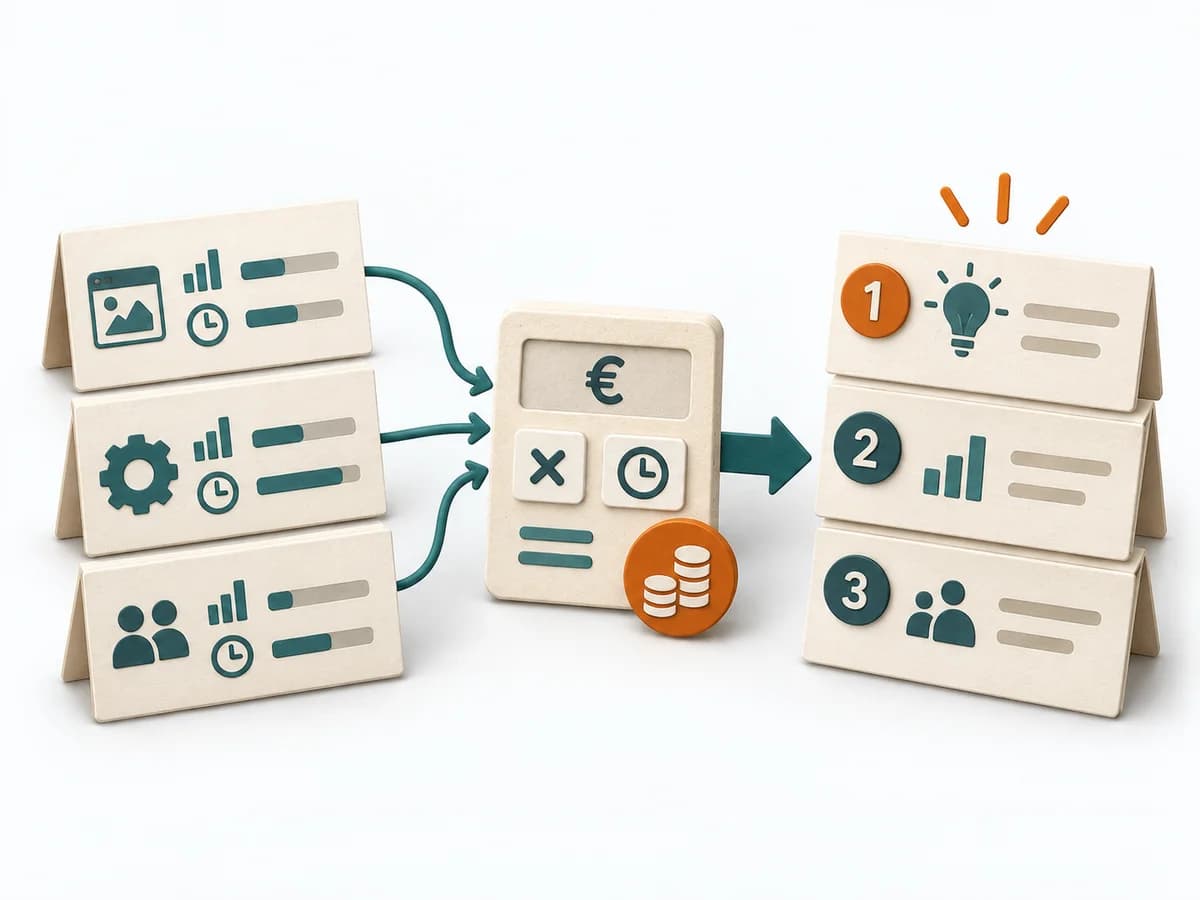 Delivery Cost of Delay |
|---|---|---|---|---|
Zweckunterschiedlich | Wenn ein Release zu viele Forderungen trägt und Prioritäten nur noch verhandelt werden, schafft MoSCoW klare Grenzen für den nächsten Zuschnitt. Must, Should, Could und Won’t machen Verbindlichkeit, Spielraum und Tauschlogik für alle Beteiligten sichtbar. | Bei einem Incident mit unklarer Reihenfolge macht die Methode den zeitlichen Verlauf präzise sichtbar. Sie trennt Wahrnehmung, Reaktion und Verzögerung, damit Ursache und Wirkung sauberer lesbar werden. | Nach einem Incident mit Schaden oder Beinahe-Schaden schafft die Methode ein nüchternes Lernfeld ohne Schuldzuweisung. Sie richtet den Blick auf Verlauf, Bedingungen und wirksame Gegenmaßnahmen. | Wenn mehrere Initiativen um knappe Kapazität konkurrieren und Verzögerung teuer werden kann, macht Cost of Delay den wirtschaftlichen Schaden sichtbar. Der Blick auf verlorenen Wert pro Zeitfenster schafft eine klare Grundlage für Reihenfolge und Taktung. |
Komplexitätunterschiedlich | Niedrig | Mittel | Mittel | Hoch |
Zeitunterschiedlich | 30-90 min | 60-180 min | 30-90 min | 90-180 min |
Teilnehmendeunterschiedlich | 3-12 | 3-10 | 3-12 | 3-8 |
Formatunterschiedlich | Workshop + Async | Workshop + Async | Workshop + Async | Workshop |
Outputunterschiedlich | Prioritized Backlog, Release Scope, Tradeoff Notes | Incident Timeline, Evidence Log, Delay Analysis, Improvement Actions | Postmortem Doc, Action Items, Timeline | CoD-Tabelle, Priorisierungssequenz |
Tagskeine Überschneidung | PriorisierungUmfangEntscheidung | IncidentZeitleisteSite Reliability Engineering | Site Reliability EngineeringIncidentLernenZuverlässigkeit | PriorisierungDeliveryÖkonomieEntscheidung |