Methoden Seite an Seite ansehen.
Wähle bis zu vier Methoden. Ergänze sie über die Suche und teile den Vergleich über seinen Link.
| Kriterium | 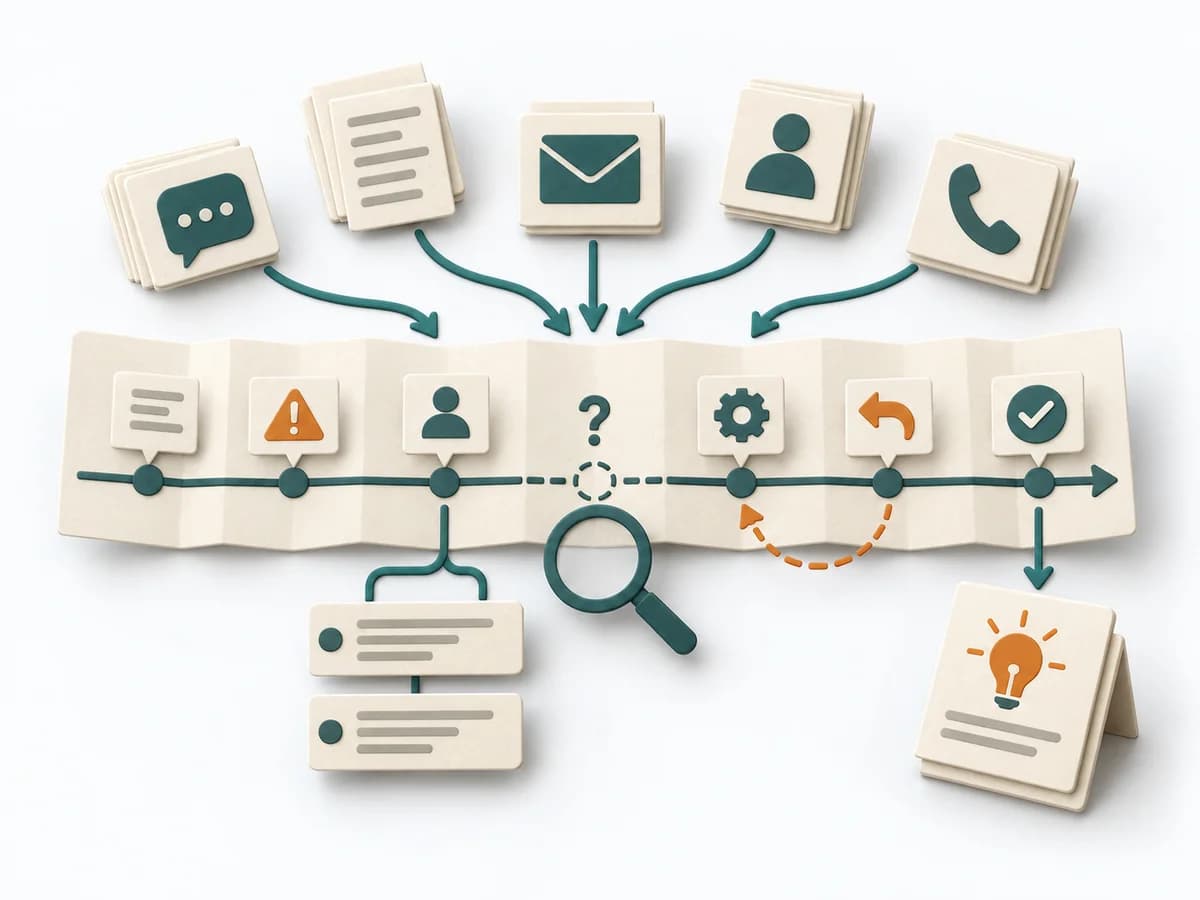 DevOps Incident Timeline Analysis | 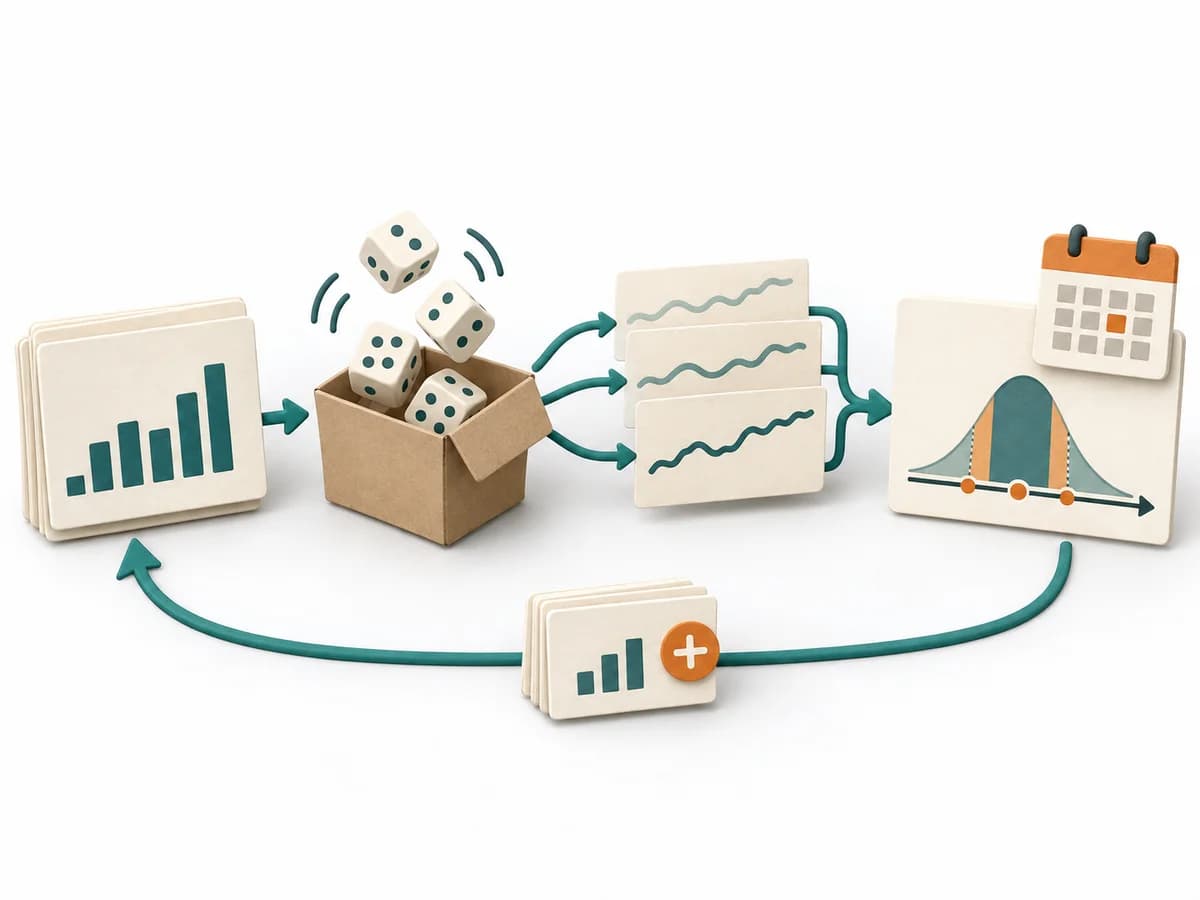 Delivery Monte Carlo Forecasting | 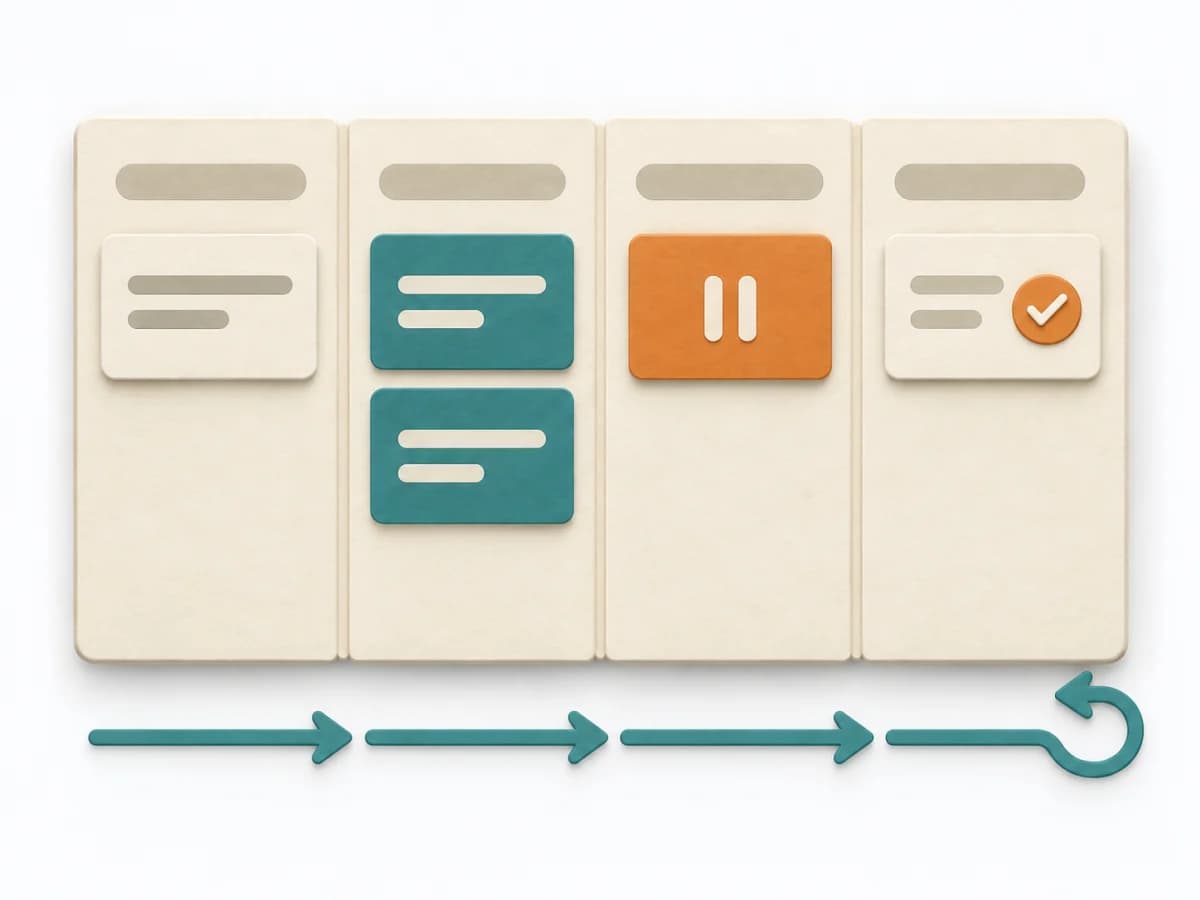 Engineering Kanban |  DevOps Blameless Postmortem |
|---|---|---|---|---|
Zweckunterschiedlich | Bei einem Incident mit unklarer Reihenfolge macht die Methode den zeitlichen Verlauf präzise sichtbar. Sie trennt Wahrnehmung, Reaktion und Verzögerung, damit Ursache und Wirkung sauberer lesbar werden. | Wenn Liefertermine unsicher sind und Einzel-Schätzungen zu viel Sicherheit vortäuschen, zeigt Monte Carlo Forecasting die Bandbreite plausibler Enddaten. Historische Flussdaten werden so nutzbar, dass Risiko, Wahrscheinlichkeit und Erwartungswert sauber auseinanderhalten bleiben. | Wenn Arbeit parallel in zu vielen Strömen steckt, leidet Durchsatz und niemand sieht die Engpässe. Kanban macht den Fluss von Arbeit sichtbar und begrenzt Überlast so, dass ein System ruhiger und vorhersagbarer wird. | Nach einem Incident mit Schaden oder Beinahe-Schaden schafft die Methode ein nüchternes Lernfeld ohne Schuldzuweisung. Sie richtet den Blick auf Verlauf, Bedingungen und wirksame Gegenmaßnahmen. |
Komplexitätunterschiedlich | Mittel | Hoch | Mittel | Mittel |
Zeitunterschiedlich | 60-180 min | 30-90 min Setup, danach laufend | Ongoing | 30-90 min |
Teilnehmendeunterschiedlich | 3-10 | 1-8 | 2-12 | 3-12 |
Formatidentisch | Workshop + Async | Workshop + Async | Workshop + Async | Workshop + Async |
Outputunterschiedlich | Incident Timeline, Evidence Log, Delay Analysis, Improvement Actions | Forecast Percentiles, Throughput Dataset, Risk Communication | Kanban Board, WIP Policies, Flow Metrics | Postmortem Doc, Action Items, Timeline |
Tagskeine Überschneidung | IncidentZeitleisteSite Reliability Engineering | PrognoseFlowDelivery | FlowVisuelles ManagementDelivery | Site Reliability EngineeringIncidentLernenZuverlässigkeit |