Methoden Seite an Seite ansehen.
Wähle bis zu vier Methoden. Ergänze sie über die Suche und teile den Vergleich über seinen Link.
| Kriterium |  Product Discovery Outcome-Driven Innovation |  DevOps Incident Command |  DevOps Blameless Postmortem | 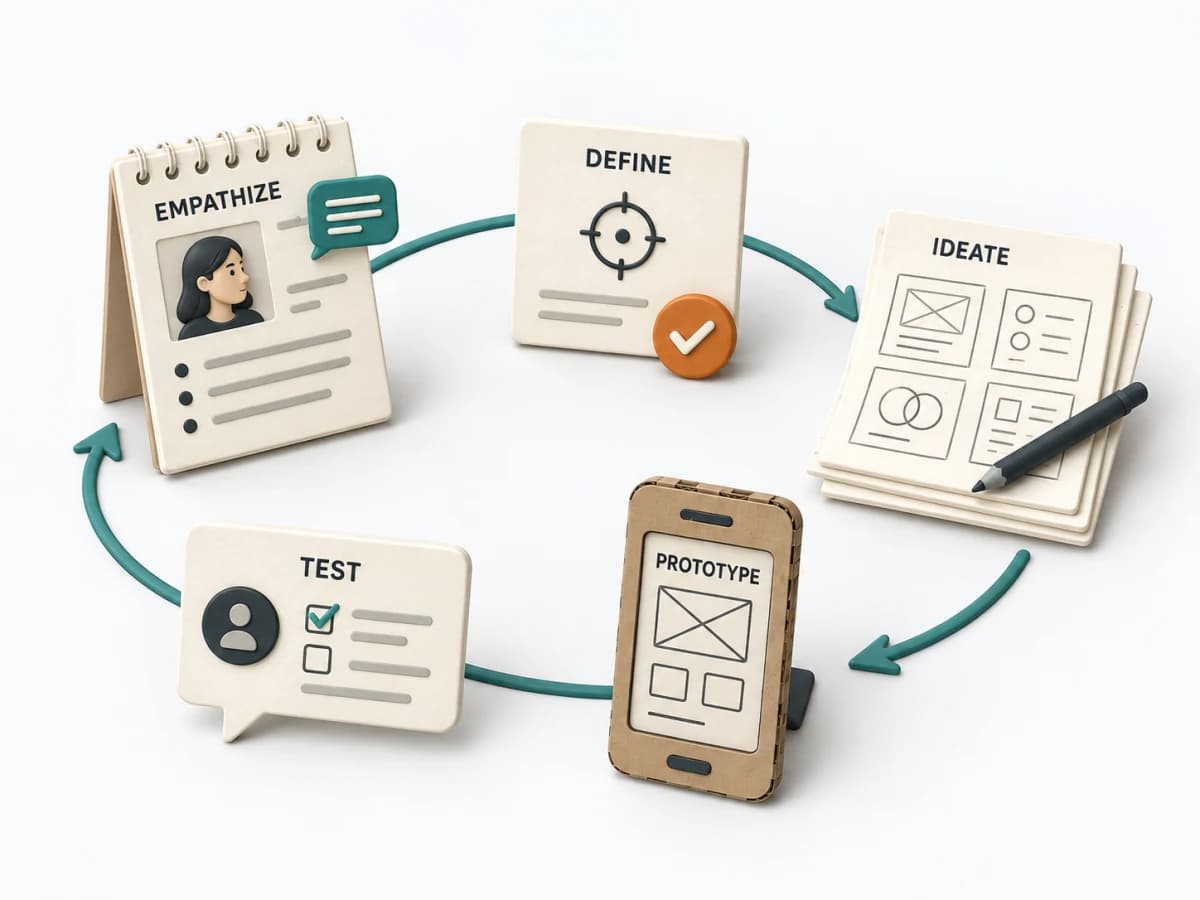 Innovation Design Thinking |
|---|---|---|---|---|
Zweckunterschiedlich | Wenn unterversorgte Bedürfnisse in einem Markt sichtbar werden sollen, verdichtet sie Outcomes zu einer Chancenlandschaft. Sie zeigt, wo Zufriedenheit und Wichtigkeit auseinanderlaufen. | Bei einem akuten Incident mit mehreren Beteiligten schafft die Methode eine klare Führungs- und Kommunikationsstruktur. Sie reduziert Chaos, wenn schnelle Koordination und saubere Lageführung gleichzeitig gebraucht werden. | Nach einem Incident mit Schaden oder Beinahe-Schaden schafft die Methode ein nüchternes Lernfeld ohne Schuldzuweisung. Sie richtet den Blick auf Verlauf, Bedingungen und wirksame Gegenmaßnahmen. | Bei komplexen Nutzerproblemen mit unsicherer Ursache verbindet die Methode Beobachtung, Deutung und Experiment zu einem Lernzyklus. Sie hält den Fokus auf reale Bedürfnisse und vermeidet vorschnelle Lösungssprache. Dadurch entstehen robuste Entscheidungen für Produkt und Service. |
Komplexitätunterschiedlich | Hoch | Mittel | Mittel | Hoch |
Zeitunterschiedlich | Mehrere Wochen | As needed | 30-90 min | 1 Tag bis mehrere Wochen |
Teilnehmendeunterschiedlich | 2-6 Researcher und Sample | 4-15 | 3-12 | 4-10 |
Formatunterschiedlich | Workshop + Async | Workshop + Async | Workshop + Async | Workshop |
Outputunterschiedlich | Desired Outcome Statements, Opportunity-Landschaft, Segmentierung nach Underserved Needs, Innovations-Hypothesen | Incident Log, Action Tracker, Stakeholder Updates | Postmortem Doc, Action Items, Timeline | Problem Statement, Prototype, Test Learnings |
Tagskeine Überschneidung | OutcomesInnovationResearchQuantitativ | IncidentOperationsZuverlässigkeit | Site Reliability EngineeringIncidentLernenZuverlässigkeit | InnovationPrototypResearch |