Methoden Seite an Seite ansehen.
Wähle bis zu vier Methoden. Ergänze sie über die Suche und teile den Vergleich über seinen Link.
| Kriterium | 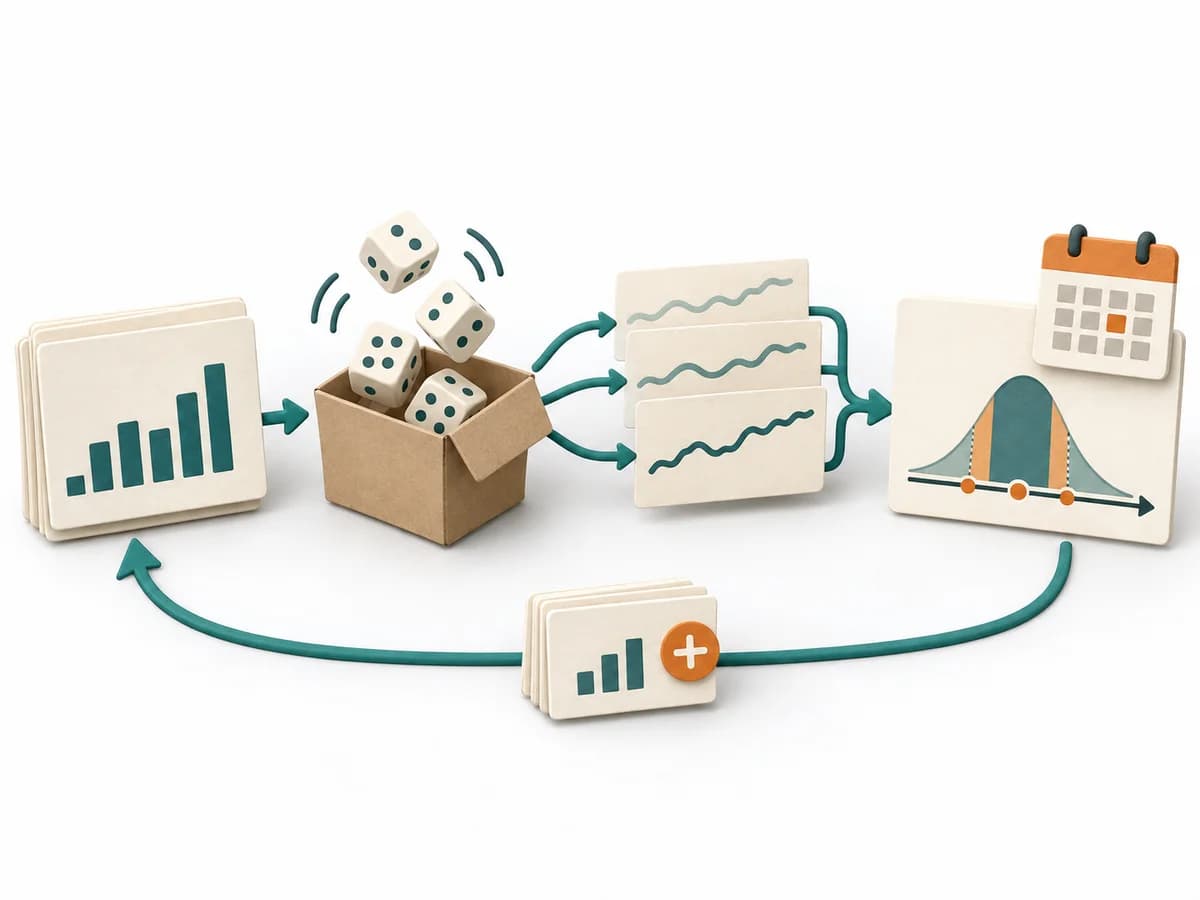 Delivery Monte Carlo Forecasting | 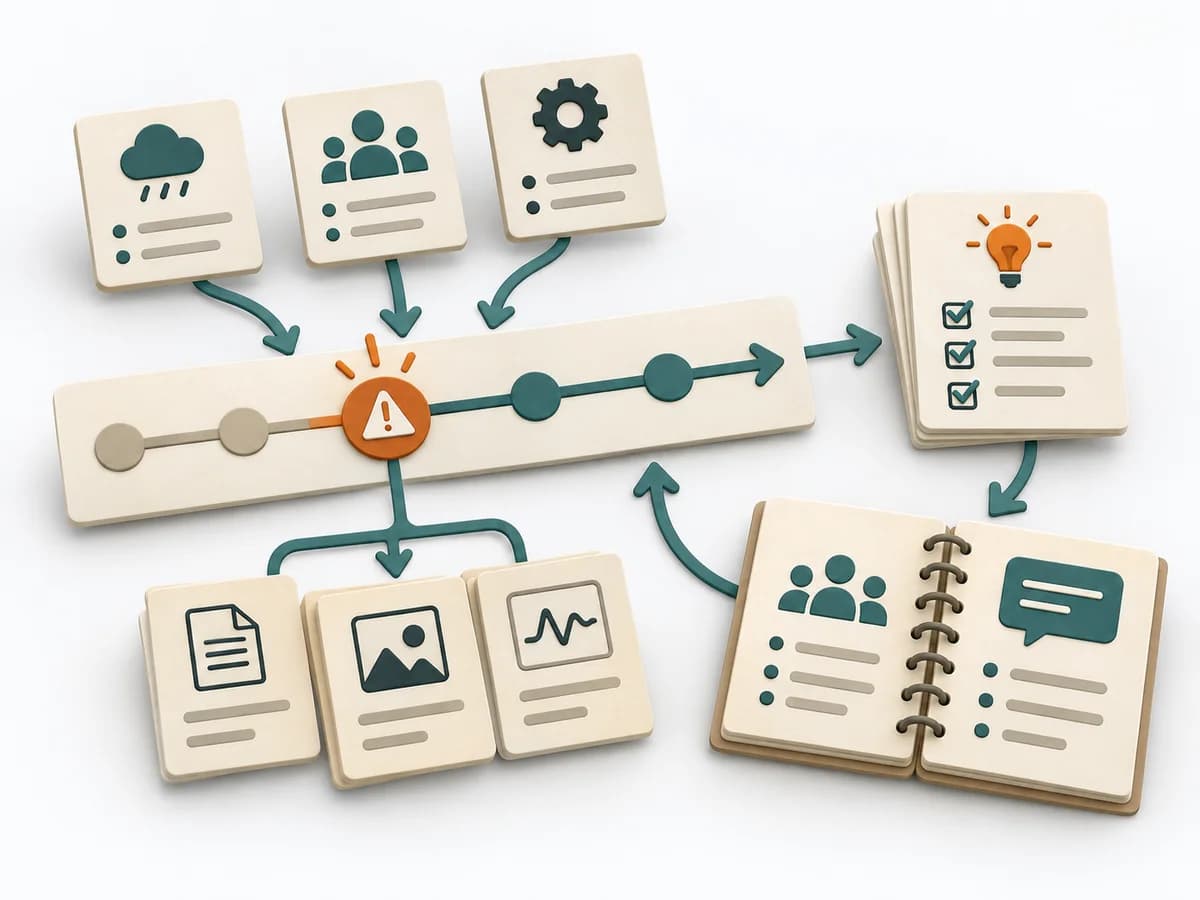 DevOps Blameless Postmortem |  Operations After-Action Review | 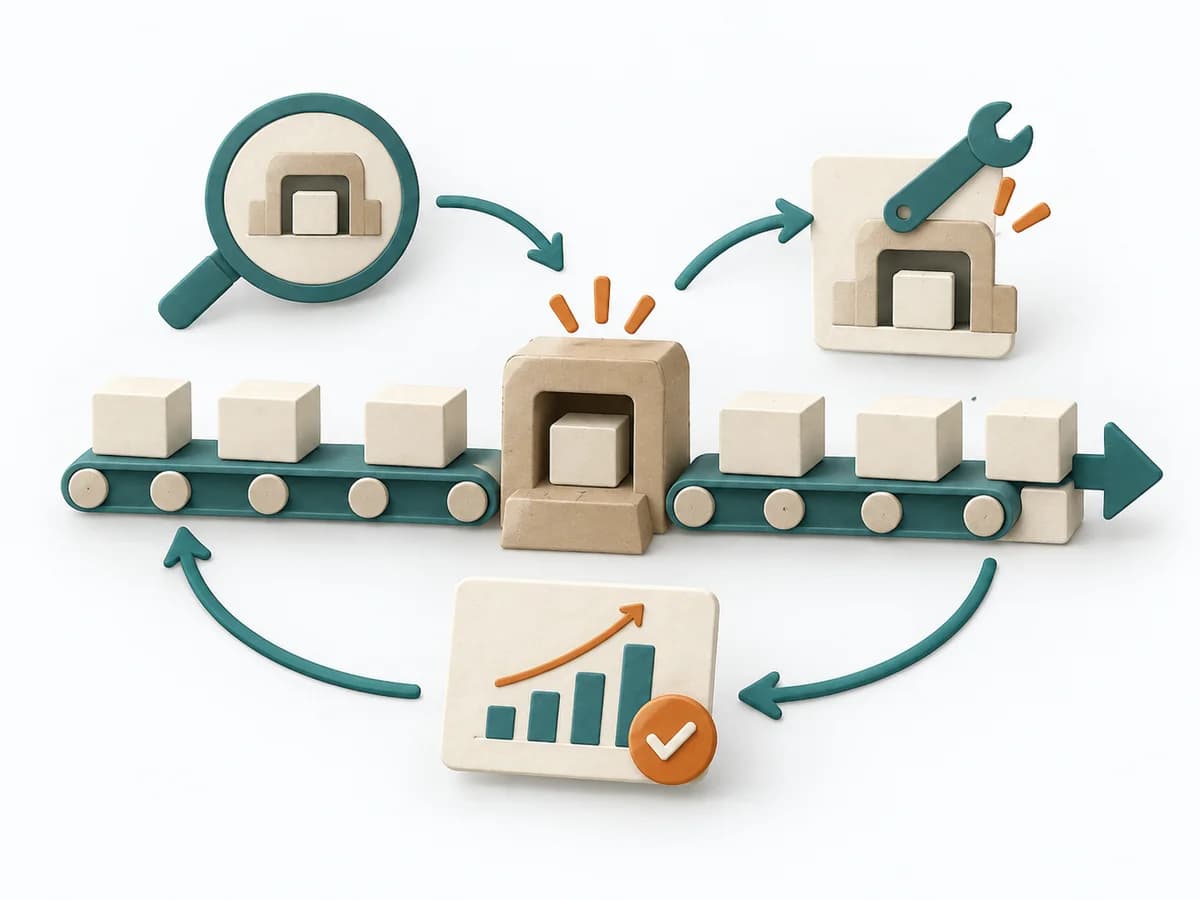 Operations Theory of Constraints |
|---|---|---|---|---|
Zweckunterschiedlich | Wenn Liefertermine unsicher sind und Einzel-Schätzungen zu viel Sicherheit vortäuschen, zeigt Monte Carlo Forecasting die Bandbreite plausibler Enddaten. Historische Flussdaten werden so nutzbar, dass Risiko, Wahrscheinlichkeit und Erwartungswert sauber auseinanderhalten bleiben. | Nach einem Incident mit Schaden oder Beinahe-Schaden schafft die Methode ein nüchternes Lernfeld ohne Schuldzuweisung. Sie richtet den Blick auf Verlauf, Bedingungen und wirksame Gegenmaßnahmen. | Nach Einsätzen oder Projektphasen mit unklaren Ergebnissen macht die Methode sichtbar, was tatsächlich passiert ist und was davon lernen lässt. Sie trennt Verlauf, Wirkung und Ursachen, damit Erfahrung in belastbare Verbesserungen übergeht. | Bei einem System, das trotz Aufwand nicht schneller wird, lenkt die Methode Aufmerksamkeit auf den Engpass. Sie konzentriert Verbesserung auf die Stelle, die den Durchsatz tatsächlich begrenzt. |
Komplexitätunterschiedlich | Hoch | Mittel | Niedrig | Hoch |
Zeitunterschiedlich | 30-90 min Setup, danach laufend | 30-90 min | 20-45 min | 2-4 h Analyse, laufend |
Teilnehmendeunterschiedlich | 1-8 | 3-12 | 3-12 | 3-12 |
Formatidentisch | Workshop + Async | Workshop + Async | Workshop + Async | Workshop + Async |
Outputunterschiedlich | Forecast Percentiles, Throughput Dataset, Risk Communication | Postmortem Doc, Action Items, Timeline | Lessons Learned, Action Items, Event Summary | Constraint Map, Improvement Plan, Flow Metrics |
Tagskeine Überschneidung | PrognoseFlowDelivery | Site Reliability EngineeringIncidentLernenZuverlässigkeit | LernenOperationsVerbesserung | OperationsRahmenbedingungenFlowVerbesserung |