Methoden Seite an Seite ansehen.
Wähle bis zu vier Methoden. Ergänze sie über die Suche und teile den Vergleich über seinen Link.
| Kriterium | 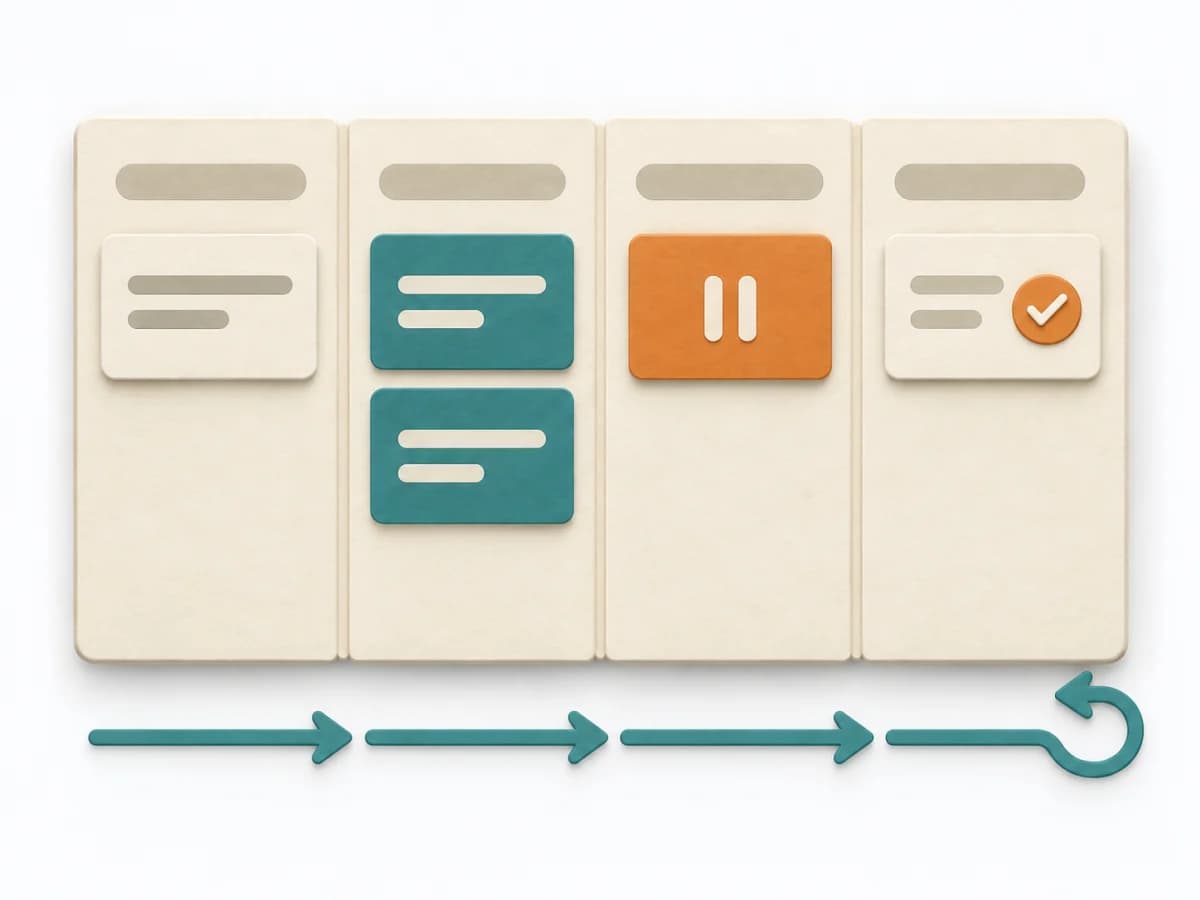 Engineering Kanban | 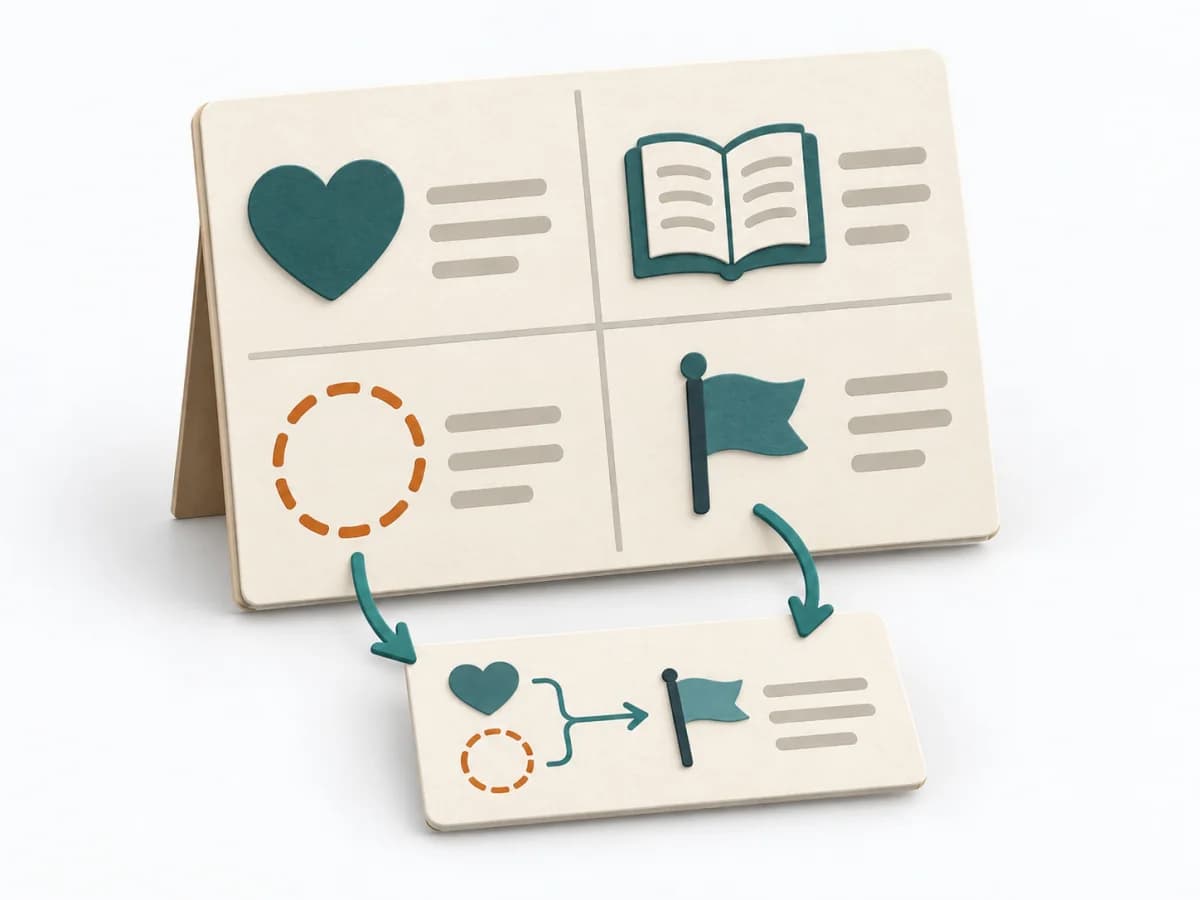 Agile 4Ls Retrospective |  DevOps Blameless Postmortem |  DevOps Incident Command |
|---|---|---|---|---|
Zweckunterschiedlich | Wenn Arbeit parallel in zu vielen Strömen steckt, leidet Durchsatz und niemand sieht die Engpässe. Kanban macht den Fluss von Arbeit sichtbar und begrenzt Überlast so, dass ein System ruhiger und vorhersagbarer wird. | Wenn ein Sprint nicht nur bewertet, sondern auch gelernt werden soll, fasst sie Erfahrung in klare Lernkategorien. Sie hält fest, was funktioniert hat, was fehlt und was nächstes Mal anders laufen soll. | Nach einem Incident mit Schaden oder Beinahe-Schaden schafft die Methode ein nüchternes Lernfeld ohne Schuldzuweisung. Sie richtet den Blick auf Verlauf, Bedingungen und wirksame Gegenmaßnahmen. | Bei einem akuten Incident mit mehreren Beteiligten schafft die Methode eine klare Führungs- und Kommunikationsstruktur. Sie reduziert Chaos, wenn schnelle Koordination und saubere Lageführung gleichzeitig gebraucht werden. |
Komplexitätunterschiedlich | Mittel | Niedrig | Mittel | Mittel |
Zeitunterschiedlich | Ongoing | 45–75 min | 30-90 min | As needed |
Teilnehmendeunterschiedlich | 2-12 | Beteiligtes Team | 3-12 | 4-15 |
Formatunterschiedlich | Workshop + Async | Workshop | Workshop + Async | Workshop + Async |
Outputunterschiedlich | Kanban Board, WIP Policies, Flow Metrics | 4Ls Board, Learning Themes, Improvement Actions | Postmortem Doc, Action Items, Timeline | Incident Log, Action Tracker, Stakeholder Updates |
Tagskeine Überschneidung | FlowVisuelles ManagementDelivery | RetrospektiveLernenReflexionTeam | Site Reliability EngineeringIncidentLernenZuverlässigkeit | IncidentOperationsZuverlässigkeit |