Methoden Seite an Seite ansehen.
Wähle bis zu vier Methoden. Ergänze sie über die Suche und teile den Vergleich über seinen Link.
| Kriterium | 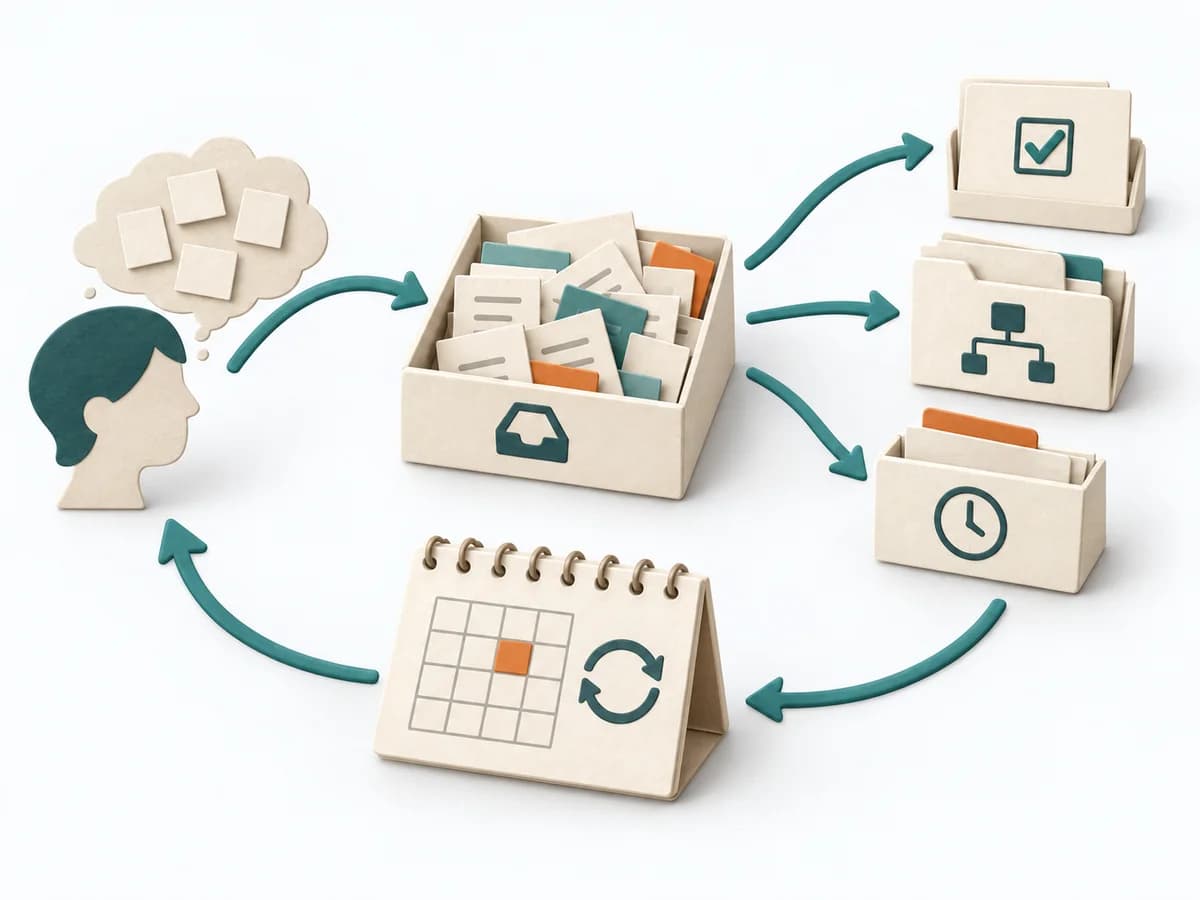 Operations Getting Things Done | 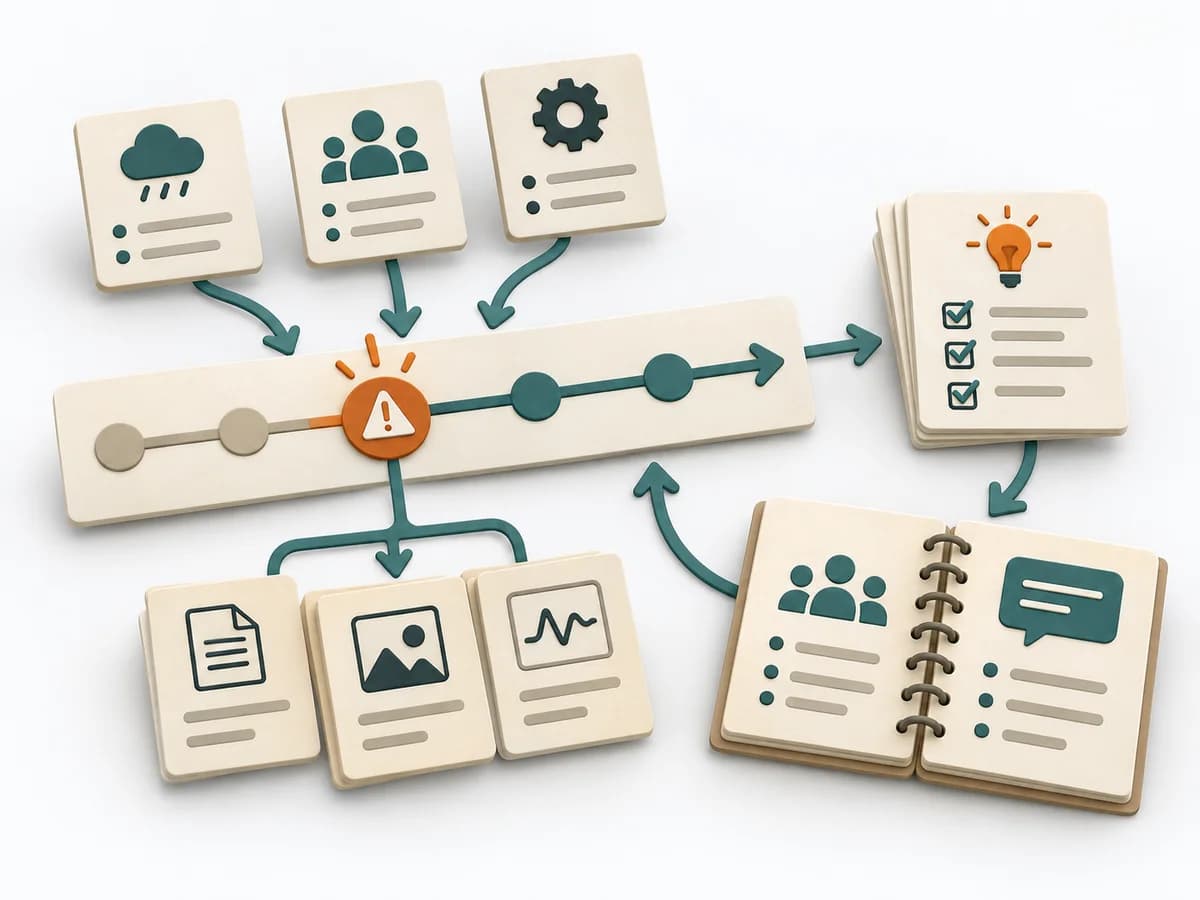 DevOps Blameless Postmortem | 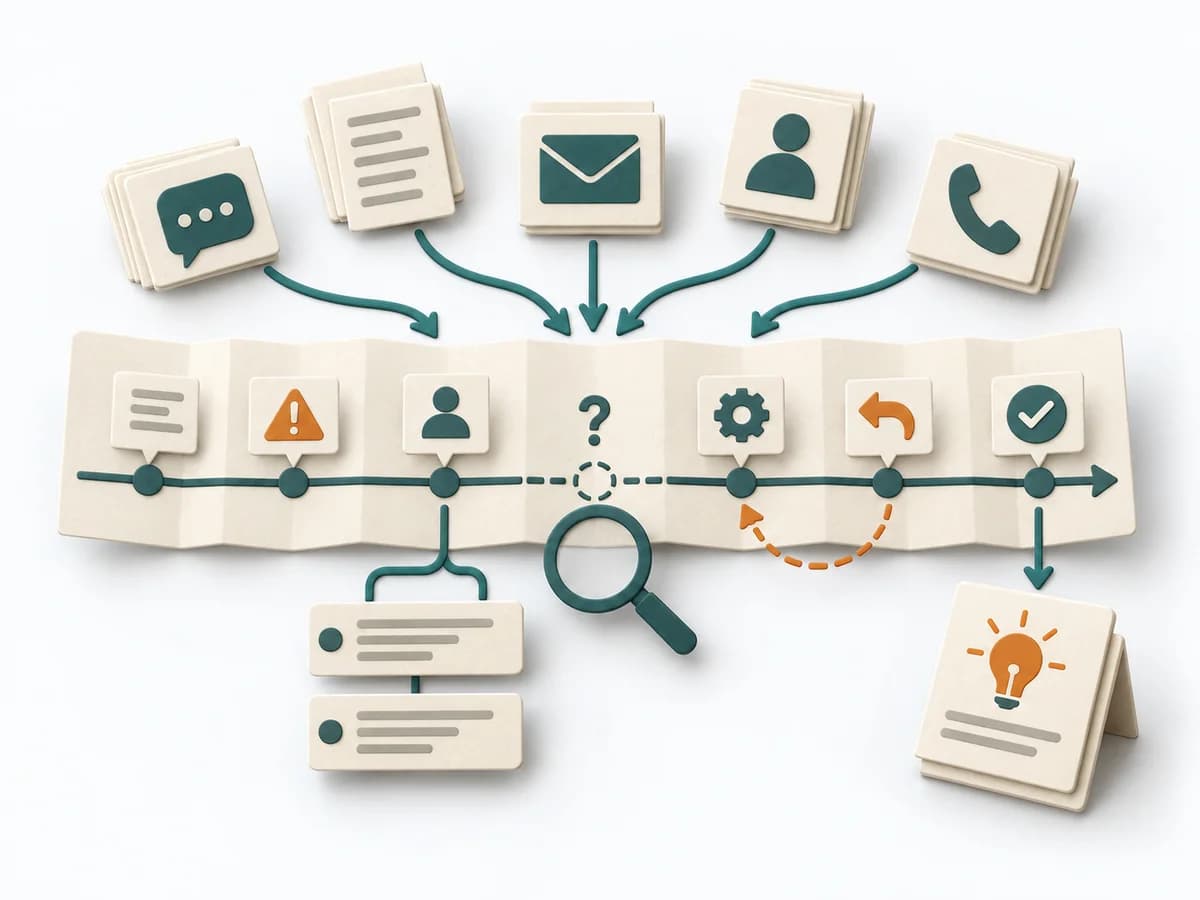 DevOps Incident Timeline Analysis | 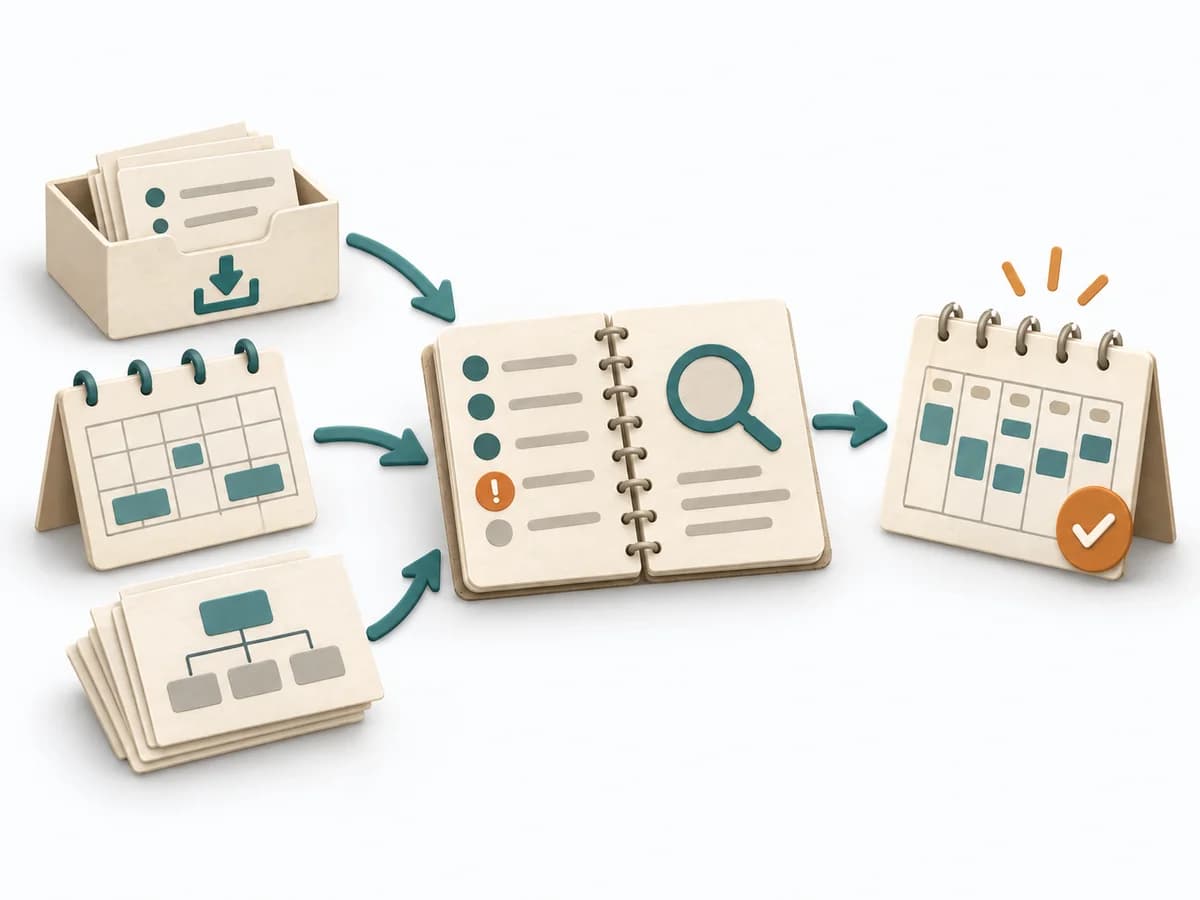 Operations Weekly Review |
|---|---|---|---|---|
Zweckunterschiedlich | Bei vielen offenen Zusagen und Ideen im Alltag entsteht ein verlässliches Außenspeicher-System. Die Methode entlastet den Kopf, damit Priorität und Kontext nicht im Gedächtnis konkurrieren müssen. | Nach einem Incident mit Schaden oder Beinahe-Schaden schafft die Methode ein nüchternes Lernfeld ohne Schuldzuweisung. Sie richtet den Blick auf Verlauf, Bedingungen und wirksame Gegenmaßnahmen. | Bei einem Incident mit unklarer Reihenfolge macht die Methode den zeitlichen Verlauf präzise sichtbar. Sie trennt Wahrnehmung, Reaktion und Verzögerung, damit Ursache und Wirkung sauberer lesbar werden. | Bei einer Woche mit vielen offenen Schleifen schafft die Methode Abstand zum operativen Lärm. Sie ordnet Zusagen, Kalender und Projekte so, dass die nächste Woche tragfähig wird. |
Komplexitätunterschiedlich | Mittel | Mittel | Mittel | Niedrig |
Zeitunterschiedlich | 1-2 h Setup, laufend | 30-90 min | 60-180 min | 30-60 min |
Teilnehmendeunterschiedlich | 1 | 3-12 | 3-10 | 1 |
Formatunterschiedlich | Async | Workshop + Async | Workshop + Async | Async |
Outputunterschiedlich | Action Lists, Project List, Review Routine | Postmortem Doc, Action Items, Timeline | Incident Timeline, Evidence Log, Delay Analysis, Improvement Actions | Updated Task System, Weekly Focus, Next Actions |
Tagskeine Überschneidung | ProduktivitätPlanungAufgabenUmsetzung | Site Reliability EngineeringIncidentLernenZuverlässigkeit | IncidentZeitleisteSite Reliability Engineering | ProduktivitätUmsetzungPlanung |