Methoden Seite an Seite ansehen.
Wähle bis zu vier Methoden. Ergänze sie über die Suche und teile den Vergleich über seinen Link.
In der Auswahl:Incident Timeline AnalysisFailure Mode and Effects AnalysisIncident CommandRoot Cause Analysis
| Kriterium | 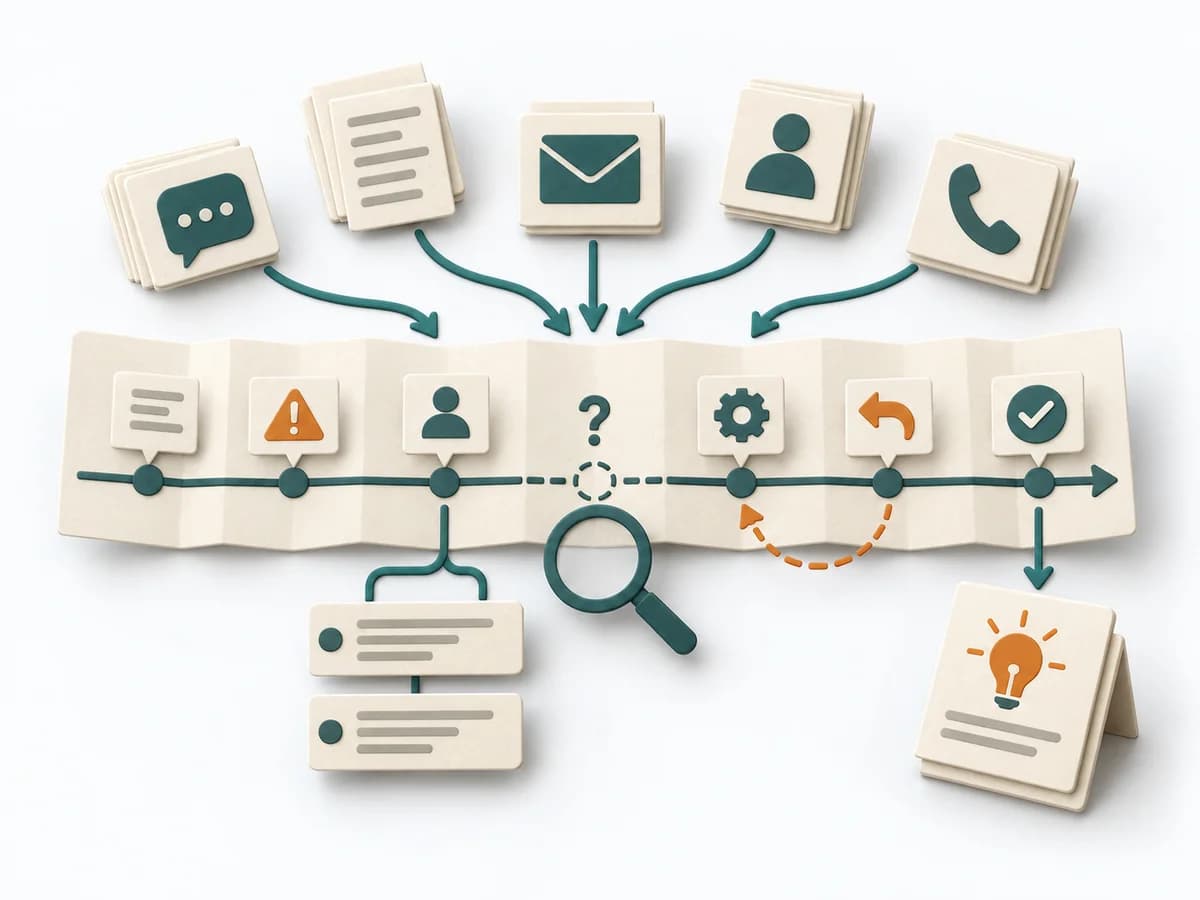 DevOps Incident Timeline Analysis | 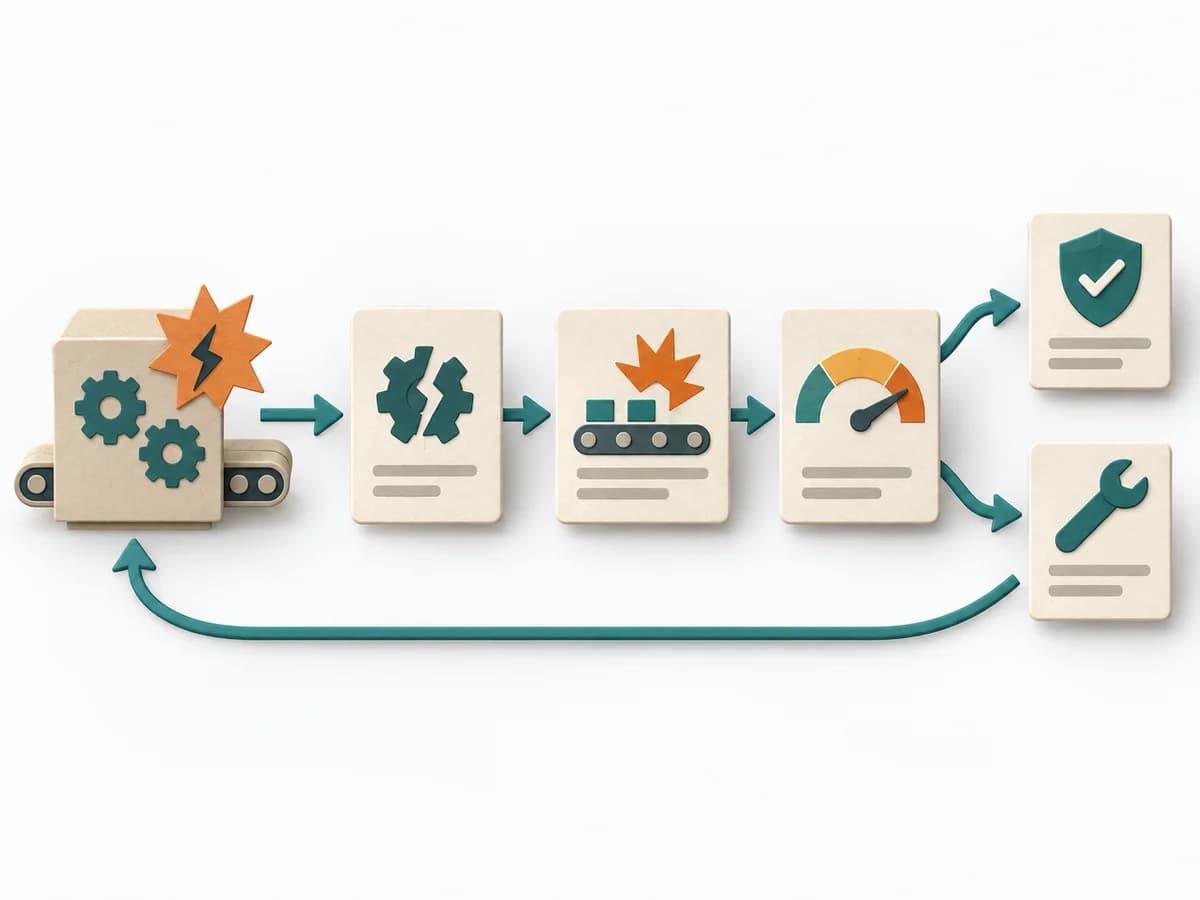 Operations Failure Mode and Effects Analysis |  DevOps Incident Command | 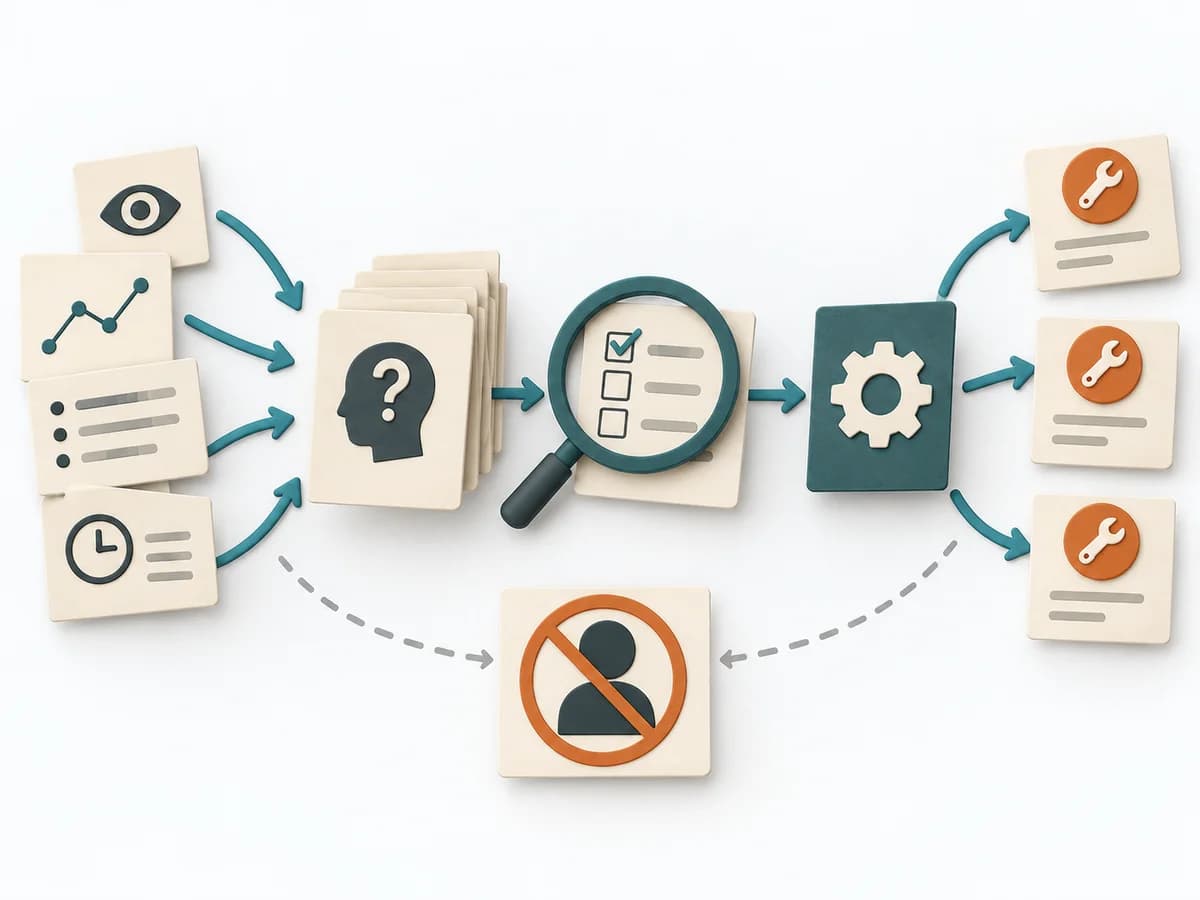 Operations Root Cause Analysis |
|---|---|---|---|---|
Zweckunterschiedlich | Bei einem Incident mit unklarer Reihenfolge macht die Methode den zeitlichen Verlauf präzise sichtbar. Sie trennt Wahrnehmung, Reaktion und Verzögerung, damit Ursache und Wirkung sauberer lesbar werden. | Bei einem Prozess, Produkt oder Service mit spürbaren Ausfallrisiken bewertet die Methode mögliche Fehlbilder vorab. Sie lenkt Aufmerksamkeit auf Kombinationen aus Eintritt, Wirkung und Entdeckbarkeit. | Bei einem akuten Incident mit mehreren Beteiligten schafft die Methode eine klare Führungs- und Kommunikationsstruktur. Sie reduziert Chaos, wenn schnelle Koordination und saubere Lageführung gleichzeitig gebraucht werden. | Wenn ein Problem wiederkehrt und die Ursache unklar bleibt, legt die Methode das zugrunde liegende Wirkgefüge frei. Sie trennt Symptom, Vermutung und belastbare Erklärung voneinander. |
Komplexitätunterschiedlich | Mittel | Hoch | Mittel | Mittel |
Zeitunterschiedlich | 60-180 min | 2-6 h | As needed | 1-4 h |
Teilnehmendeunterschiedlich | 3-10 | 3-10 | 4-15 | 3-8 |
Formatunterschiedlich | Workshop + Async | Workshop | Workshop + Async | Workshop + Async |
Outputunterschiedlich | Incident Timeline, Evidence Log, Delay Analysis, Improvement Actions | FMEA Table, Risk Priority, Mitigation Actions | Incident Log, Action Tracker, Stakeholder Updates | Problem Statement, Ursachenhypothesen, Bestätigte Ursachen, Maßnahmenplan |
Tagskeine Überschneidung | IncidentZeitleisteSite Reliability Engineering | RisikoQualitätOperationsUrsachenanalyse | IncidentOperationsZuverlässigkeit | UrsachenanalyseProblemlösungQualitätIncident |