Methoden Seite an Seite ansehen.
Wähle bis zu vier Methoden. Ergänze sie über die Suche und teile den Vergleich über seinen Link.
| Kriterium | 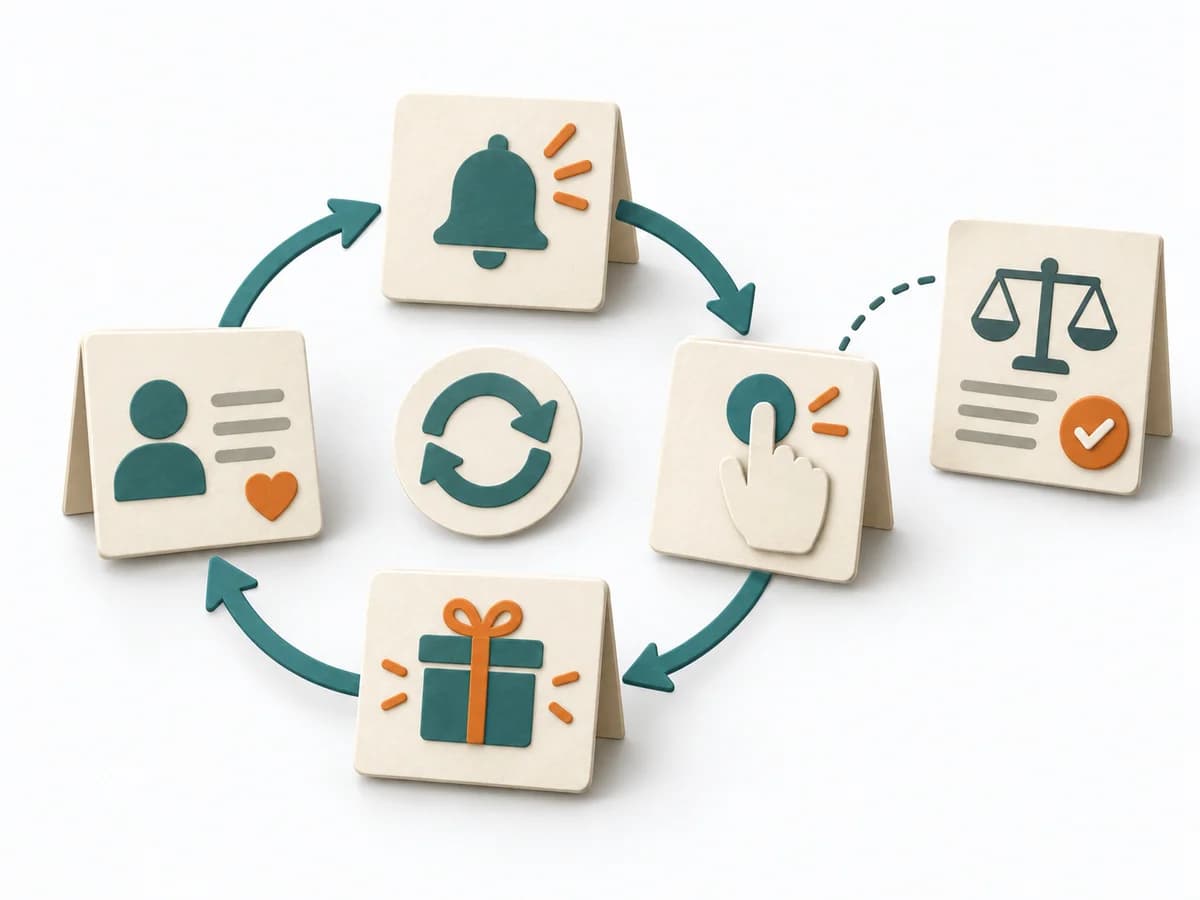 Growth Hooked Model |  DevOps Incident Command | 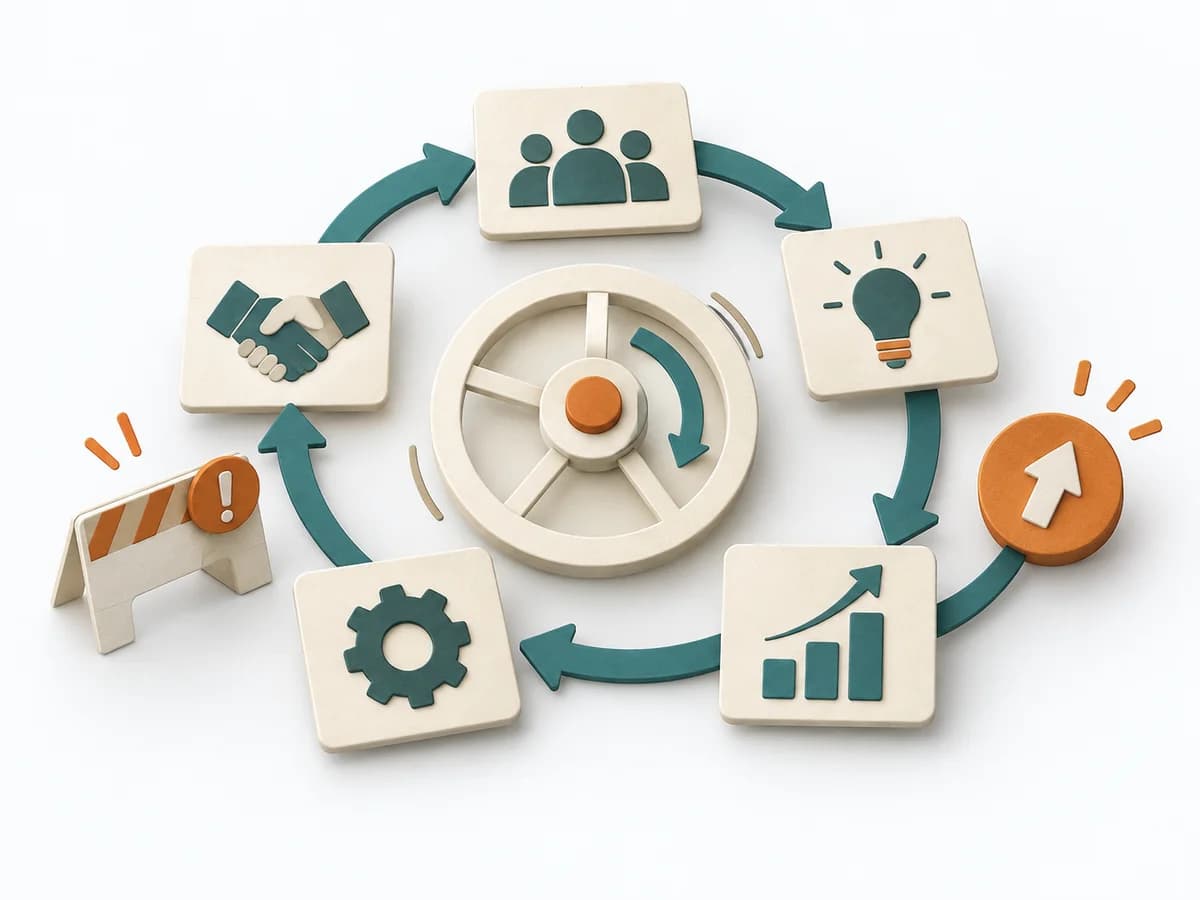 Growth Flywheel |  DevOps Blameless Postmortem |
|---|---|---|---|---|
Zweckunterschiedlich | Bei Produkten mit hoher Wiederkehr zählt nicht nur erster Kontakt, sondern routinisierte Rückkehr. Das Hooked Model beschreibt, wie externe oder interne Auslöser, einfache Aktion, Belohnung und Investition zu einem stabilen Nutzungsritual werden. | Bei einem akuten Incident mit mehreren Beteiligten schafft die Methode eine klare Führungs- und Kommunikationsstruktur. Sie reduziert Chaos, wenn schnelle Koordination und saubere Lageführung gleichzeitig gebraucht werden. | Wachstum bricht oft dort ein, wo ein Verstärkungsmechanismus zu viel Reibung aufbaut. Ein Flywheel zeigt den Kreislauf aus Nutzen, Wiederholung und Verstärkung, der nachhaltiges Wachstum tragen soll. | Nach einem Incident mit Schaden oder Beinahe-Schaden schafft die Methode ein nüchternes Lernfeld ohne Schuldzuweisung. Sie richtet den Blick auf Verlauf, Bedingungen und wirksame Gegenmaßnahmen. |
Komplexitätidentisch | Mittel | Mittel | Mittel | Mittel |
Zeitunterschiedlich | Mehrere Workshops über Wochen | As needed | 60-120 min | 30-90 min |
Teilnehmendeunterschiedlich | 2-8 | 4-15 | 3-8 | 3-12 |
Formatunterschiedlich | Workshop + Async | Workshop + Async | Workshop | Workshop + Async |
Outputunterschiedlich | Hooked Loop, Trigger-Map, Reward-Design, Ethik-Check | Incident Log, Action Tracker, Stakeholder Updates | Flywheel Map, Friction Points, Growth Levers, Experiment Backlog | Postmortem Doc, Action Items, Timeline |
Tagskeine Überschneidung | GrowthVerhaltenRetention | IncidentOperationsZuverlässigkeit | GrowthRetentionConversion | Site Reliability EngineeringIncidentLernenZuverlässigkeit |