Methoden Seite an Seite ansehen.
Wähle bis zu vier Methoden. Ergänze sie über die Suche und teile den Vergleich über seinen Link.
| Kriterium |  Operations After-Action Review | 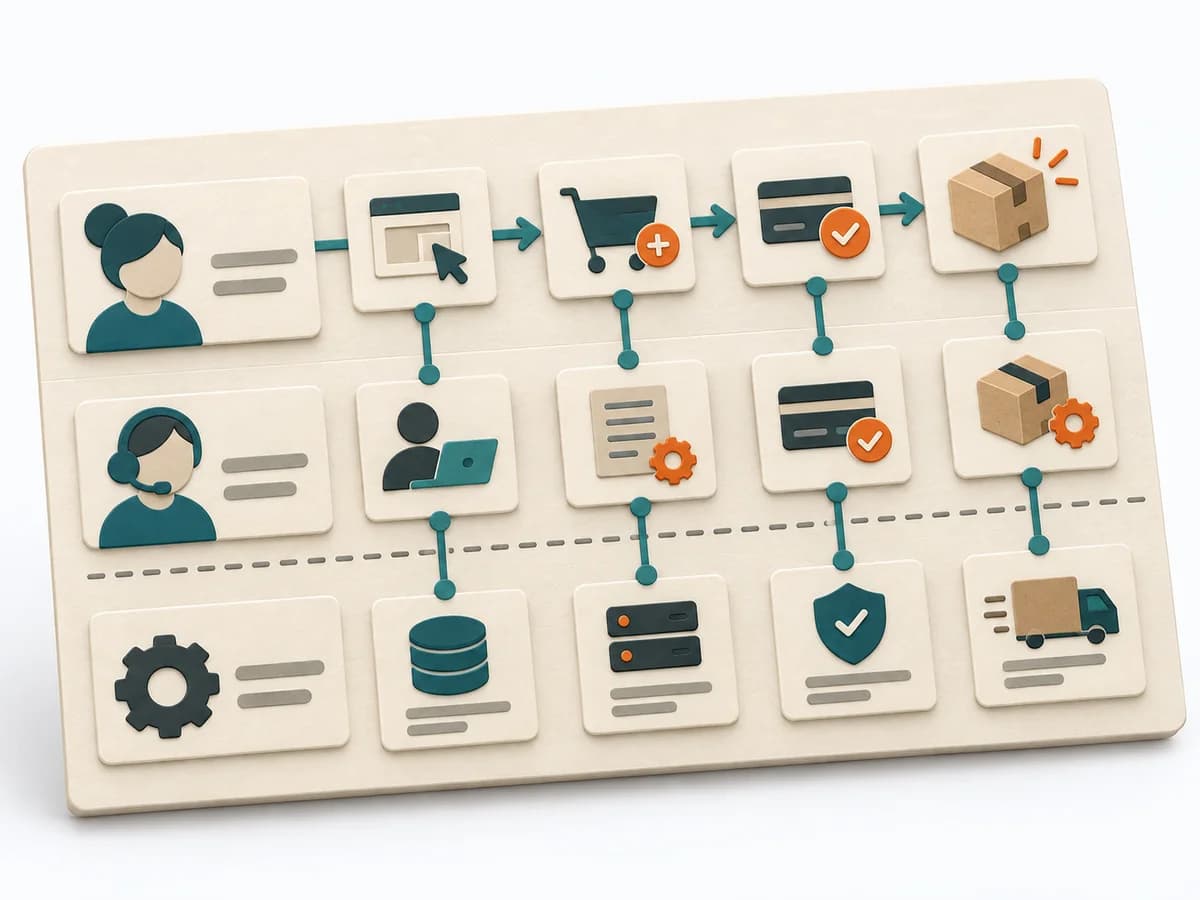 UX Design Service Blueprinting |  DevOps Blameless Postmortem |  DevOps Incident Command |
|---|---|---|---|---|
Zweckunterschiedlich | Nach Einsätzen oder Projektphasen mit unklaren Ergebnissen macht die Methode sichtbar, was tatsächlich passiert ist und was davon lernen lässt. Sie trennt Verlauf, Wirkung und Ursachen, damit Erfahrung in belastbare Verbesserungen übergeht. | Wenn eine Serviceerfahrung über mehrere Kontaktpunkte verteilt ist, bringt sie Frontstage und Backstage zusammen. Sie zeigt, wo Nutzerkontakt und interne Verantwortung zusammenpassen müssen. | Nach einem Incident mit Schaden oder Beinahe-Schaden schafft die Methode ein nüchternes Lernfeld ohne Schuldzuweisung. Sie richtet den Blick auf Verlauf, Bedingungen und wirksame Gegenmaßnahmen. | Bei einem akuten Incident mit mehreren Beteiligten schafft die Methode eine klare Führungs- und Kommunikationsstruktur. Sie reduziert Chaos, wenn schnelle Koordination und saubere Lageführung gleichzeitig gebraucht werden. |
Komplexitätunterschiedlich | Niedrig | Hoch | Mittel | Mittel |
Zeitunterschiedlich | 20-45 min | 0.5-2 Tage | 30-90 min | As needed |
Teilnehmendeunterschiedlich | 3-12 | 6-12 | 3-12 | 4-15 |
Formatunterschiedlich | Workshop + Async | Workshop | Workshop + Async | Workshop + Async |
Outputunterschiedlich | Lessons Learned, Action Items, Event Summary | Service Blueprint, Fail Points, Ownership Map | Postmortem Doc, Action Items, Timeline | Incident Log, Action Tracker, Stakeholder Updates |
Tagskeine Überschneidung | LernenOperationsVerbesserung | Service DesignOperationsJourneyBlueprint | Site Reliability EngineeringIncidentLernenZuverlässigkeit | IncidentOperationsZuverlässigkeit |