Methoden Seite an Seite ansehen.
Wähle bis zu vier Methoden. Ergänze sie über die Suche und teile den Vergleich über seinen Link.
| Kriterium | 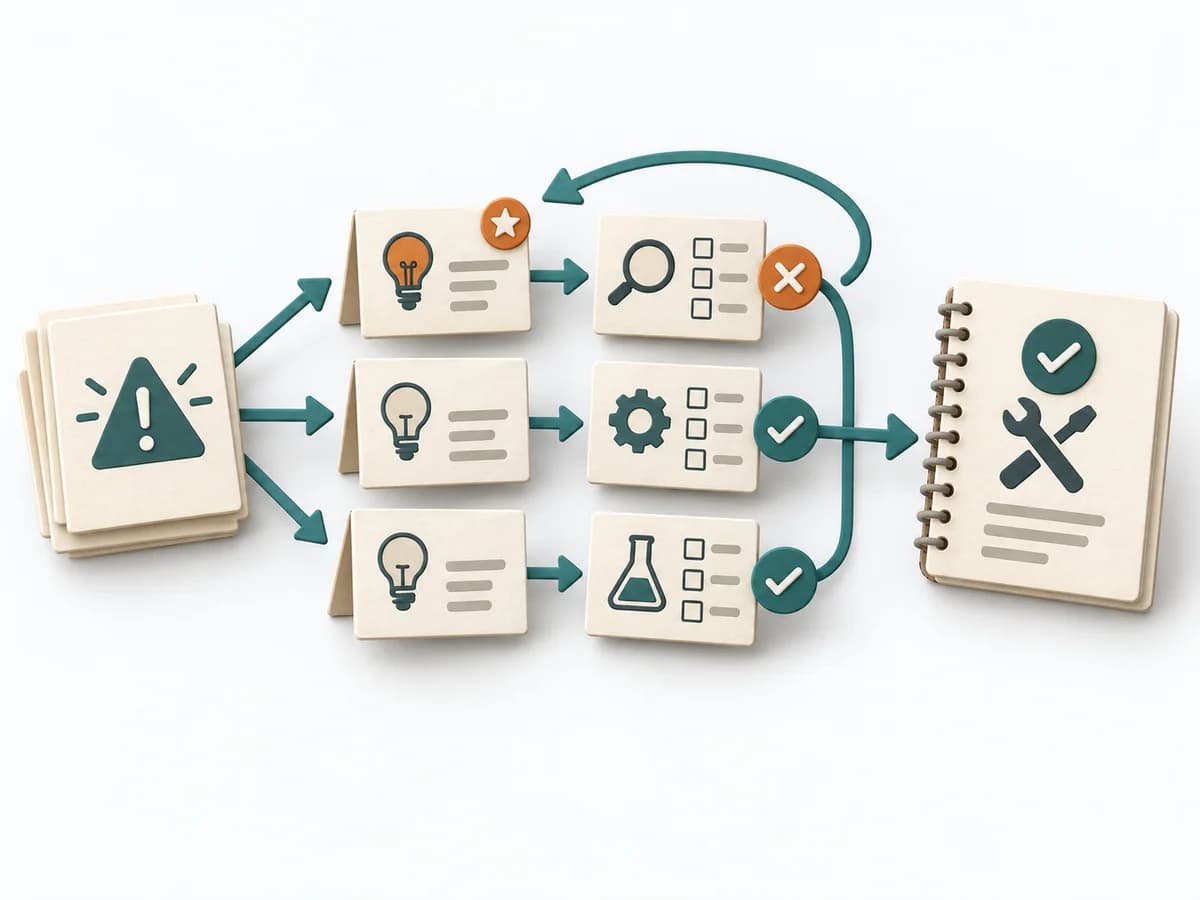 Engineering Hypothesis-Driven Troubleshooting |  DevOps Game Day | 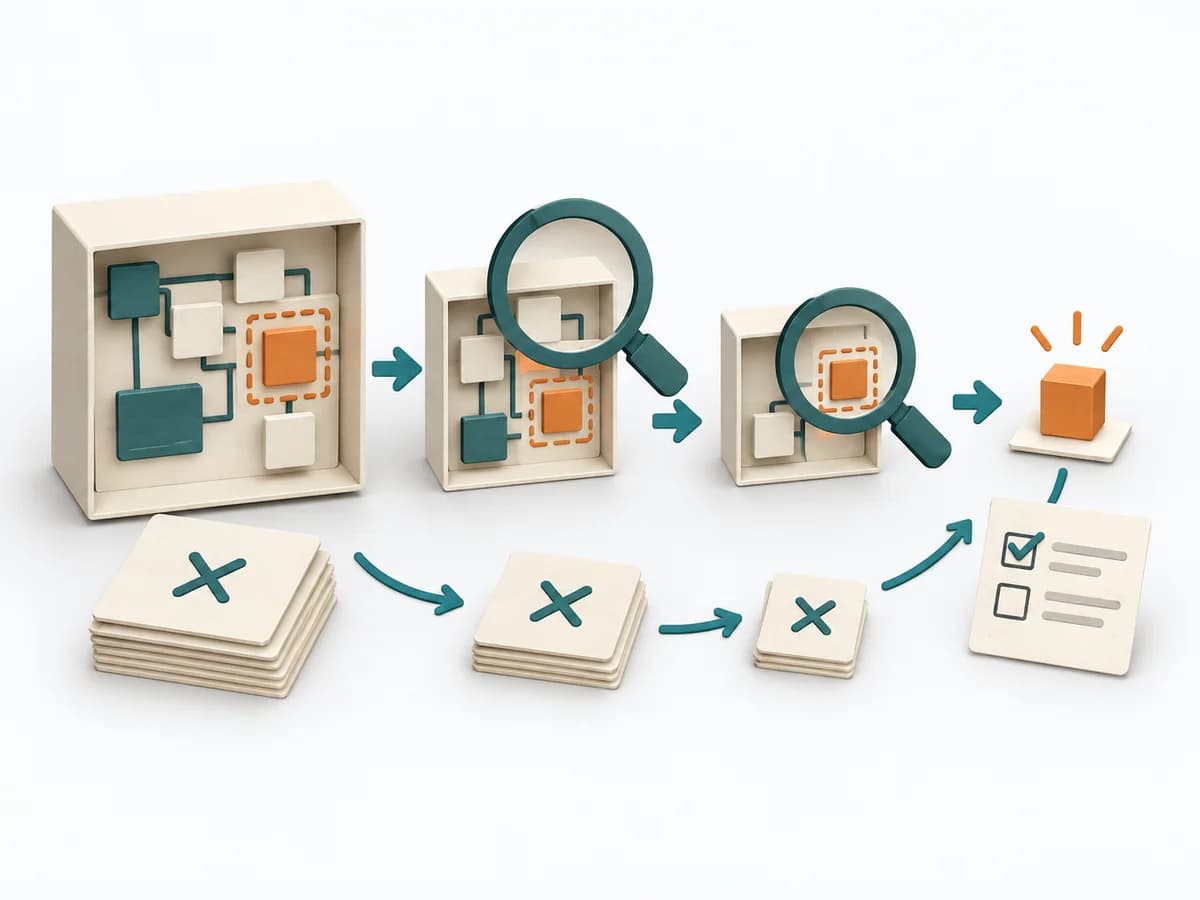 Engineering Fault Isolation |  DevOps Incident Command |
|---|---|---|---|---|
Zweckunterschiedlich | Wenn Systeme unerwartet ausfallen, liefern spontane Versuche oft mehr Lärm als Erkenntnis. Hypothesis-driven Troubleshooting übersetzt Symptome in überprüfbare Annahmen und macht die Fehlersuche lernbar. | Bei der Vorbereitung auf seltene Störungen testet die Methode Reaktionsfähigkeit unter kontrollierten Bedingungen. Sie zeigt, wo Annahmen über Stabilität, Rollen und Wiederherstellung zu optimistisch sind. | Bei technischen Störungen vermischt sich oft das sichtbare Symptom mit der eigentlichen Ursache. Fault Isolation grenzt den Fehlerraum ein und reduziert schrittweise, welcher Teil des Systems wirklich betroffen ist. | Bei einem akuten Incident mit mehreren Beteiligten schafft die Methode eine klare Führungs- und Kommunikationsstruktur. Sie reduziert Chaos, wenn schnelle Koordination und saubere Lageführung gleichzeitig gebraucht werden. |
Komplexitätunterschiedlich | Mittel | Hoch | Mittel | Mittel |
Zeitunterschiedlich | 30-240 min | Halber Tag | 30-180 min | As needed |
Teilnehmendeunterschiedlich | 1-6 | 5-20 | 1-6 | 4-15 |
Formatunterschiedlich | Workshop + Async | Workshop | Workshop + Async | Workshop + Async |
Outputunterschiedlich | Hypothesis Log, Test Plan, Evidence Notes, Diagnosis Summary | Simulation Notes, Gaps List, Updated Runbooks | Fault Isolation Map, Test Log, Ausgeschlossene Hypothesen, Eingegrenzter Fehlerbereich | Incident Log, Action Tracker, Stakeholder Updates |
Tagskeine Überschneidung | FehlersucheProblemlösungDiagnose | ResilienzOperationsIncident | FehlersucheDiagnoseEngineering | IncidentOperationsZuverlässigkeit |